
Research
Die Theoreme fallen. Das EBIT der Unternehmen steht still. Die Lücke ist nicht die Technologie.
Die Theoreme fallen. Das EBIT der Unternehmen steht still. Die Lücke ist nicht die Technologie.
Dr. Anoj Winston Gladius
·
18
Min. Lesezeit

KI als Brücke zwischen Unternehmen und Engineering-Werkzeugen.
aufsatz
Bild: KI generiert mit neuland.ai HUB
Am 8. September 2026 gab OpenAI bekannt, dass ein unveröffentlichtes internes Modell eine Lösung für das Navier-Stokes-Existenz- und Glattheitsproblem hervorgebracht hatte - eines der sieben Millennium-Probleme, die das Clay Mathematics Institute im Jahr 2000 ausgeschrieben hat. Das System lief als Multi-Agenten-Architektur, die zeitweise zehntausend Sub-Agenten an verschiedenen Teilen und Varianten des Problems arbeiten ließ, achtundachtzig Stunden benötigte und einen Beweis in Lean erzeugte, der formalen Verifikationssprache, sodass das Argument von einem Kernel geprüft werden konnte, statt auf Behauptung hin geglaubt werden zu müssen. Zwei Wochen zuvor, am 25. August, hatte McKinsey seine State-of-AI-Umfrage veröffentlicht: 1.719 Befragte aus 97 Ländern, erhoben von Mai bis Anfang Juni. Achtzig Prozent der Organisationen berichten von individuellen Produktivitätsgewinnen durch KI. Siebenunddreißig Prozent berichten von irgendeiner Auswirkung auf das Ergebnis. Diese zweite Zahl ist gegenüber dem Vorjahr unverändert. Der Anteil der Befragten, die fünf Prozent oder mehr ihres EBIT auf KI zurückführen, liegt bei ungefähr sechs Prozent, und auch er hat sich nicht bewegt. In derselben Vierzehntagesspanne hat also künstliche Intelligenz ein Problem geschlossen, das seit 1934 offen war, und es im zweiten Jahr in Folge nicht geschafft, das Ergebnis der Unternehmen zu bewegen, die dafür bezahlen. Die bequeme Lesart ist, dass die Forschung der Praxis voraus ist und die Unternehmen aufholen werden. Ich halte diese Lesart für falsch, und ich halte sie für teuer. Die Wissenschaft funktioniert nicht, weil die Modelle besser sind als die, die Unternehmen haben. Sie funktioniert, weil die Systeme, die um diese Modelle herum gebaut wurden, Eigenschaften haben, die fast nichts besitzt, was in den Unternehmensmarkt verkauft wird. Und der Grund, warum Unternehmen den Unterschied nicht erkennen können, ist, dass der Markt aufgehört hat, Tiefe zu belohnen - so weit, dass eine gut aufgenommene Ankündigung einer Agentenplattform in dieser Saison die automatische Archivierung der Agenten war, die niemand nutzt, eine sinnvolle Aufräumfunktion, die den Grund, warum sie ungenutzt sind, vollständig unberührt lässt.
Dies ist der dreiundzwanzigste Beitrag einer Serie, die ich für neuland.ai schreibe. [¹] Er ist direkter als die vorangegangenen zweiundzwanzig, weil ich ein Jahr lang strukturell argumentiert habe und die Zahlen das strukturelle Argument jetzt dringend gemacht haben.
Was in der Mathematik tatsächlich passiert ist
Die Navier-Stokes-Ankündigung kam inmitten eines Prioritätsstreits, und der Streit ist es wert, verstanden statt übersprungen zu werden, weil die ehrliche Fassung der Geschichte lehrreicher ist als die Pressemitteilung.
Tristan Buckmaster vom Courant Institute der NYU und Levent Alpöge von Harvard hatten rund ein Jahr an dem Problem gearbeitet, aufbauend auf einem Ansatz von Córdoba und Martínez-Zoroa. Am 15. August bewiesen sie, dass die Euler-Gleichungen - die reibungsfreie Vereinfachung von Navier-Stokes - tatsächlich aufblasen, unter Verwendung von Modellen von Anthropic und OpenAI, und verifizierten das Ergebnis in Lean. Am 7. September veröffentlichten sie dieses Ergebnis und erklärten, sie hätten eine Lösung des allgemeineren Problems erhalten. OpenAI richtete nach eigener Darstellung am 1. September seine Ressourcen auf Navier-Stokes, nachdem Gerüchte über deren Arbeit aufgekommen waren, und gab am 8. September seine Ankündigung heraus. Buckmaster hat OpenAI öffentlich vorgeworfen, die Entdeckung vereinnahmen zu wollen. [²]
Ich bin nicht in der Position, das zu beurteilen, und ich werde es nicht versuchen. Was hier zählt, ist das, worüber beide Darstellungen übereinstimmen, und es ist die Beschreibung einer Architektur, nicht eines Modells.
Es gab tiefe fachliche Verankerung. Ein Jahr Expertenarbeit, innerhalb eines spezifischen mathematischen Rahmens, von Menschen, die verstanden, welche Angriffslinien plausibel waren. Die Modelle haben nicht entschieden, was versucht werden soll.
Es gab modellagnostische Orchestrierung. Modelle von mindestens zwei konkurrierenden Anbietern wurden eingesetzt, gewählt pro Teilproblem. Niemand, der beteiligt war, hat sich darum geschert, wessen Logo auf der Inferenz stand.
Es gab einen deterministischen Verifikationsschritt. Dem Beweis wird vertraut, weil Leans Kernel ihn geprüft hat. Nicht weil ein Modell ihn behauptet hat, nicht weil ein Gutachter ihn überzeugend fand, und nicht weil er flüssig zu lesen war - was wichtig ist, weil der Beweis nach Buckmasters Darstellung in natürlicher Sprache kaum lesbar war und die Schritte für andere Forscher manuell rekonstruiert werden mussten.
Es gab eine massive parallele Zerlegung mit dauerhaftem Zustand. Tausende von Unteragenten in einem Aufgabengraf, die tagelang liefen, wobei sich die Ergebnisse ansammelten, anstatt zu verfliegen.
Und an der Schnittstelle kam Expertenurteil zum Tragen. Menschen entschieden, was die Ausgabe bedeutete, und machten sie verständlich.
Fünf Eigenschaften. Und jetzt halten Sie diese Liste neben das, woraus ein typischer KI-Einsatz im Unternehmen besteht: eine Chat-Oberfläche, ein Vektorspeicher, ein System-Prompt und ein Abonnement.
Warum die McKinsey-Zahlen stimmen und die Interpretation falsch ist
Die Umfrage misst nicht eine Technologie, die nicht funktioniert. Sie misst den Einsatz von etwas, das nie gebaut wurde, um zu funktionieren.
Sehen Sie sich an, was derselbe Bericht noch fand. Zweiunddreißig Prozent der Organisationen lehnten mindestens einen Softwarekauf ab, weil agentische Coding-Werkzeuge es ihnen ermöglichten, selbst zu bauen. Große Unternehmen, die Agenten in einer oder mehreren Funktionen skalieren, stiegen in einem Jahr von siebenundzwanzig auf vierzig Prozent, während kleinere Organisationen bei zweiundzwanzig stehen blieben. Zwanzig Prozent berichten, dass KI-Betriebskosten, einschließlich Token-Kosten, ihren Einsatz von KI bereits eingeschränkt haben. [³]
Liest man diese Zahlen zusammen, ergibt sich kein Bild einer Technologie, die nicht liefert. Es ist das Bild eines Marktes, in dem die Fähigkeit real ist, konzentriert in Organisationen, die Plattform- und Governance-Kapazität haben, teuer im Betrieb und größtenteils als Produktivitätswerkzeug eingesetzt statt als Engineering-Fähigkeit. Achtzig Prozent fühlen sich schneller. Siebenunddreißig Prozent finden es in den Büchern. Diese Lücke ist genau das, was man vorhersagen würde, wenn ein großer Anteil der KI-Ausgaben im Unternehmen auf Oberflächen statt auf Systeme gegangen wäre.
Unabhängige Zahlen weisen in dieselbe Richtung. Gartner kommt auf rund siebzehn Prozent der Organisationen, die tatsächlich Agenten eingesetzt haben. Deloitte setzt produktionsreife agentische Systeme bei ungefähr elf Prozent an. [⁴] Niemand scheitert an der Einführung, weil die Modelle unzureichend wären. GLM, Kimi, Claude, GPT und ihre Open-Weight-Pendants sind alle, an diesem Punkt, zu weit mehr fähig als die meisten Unternehmen von ihnen verlangen.
Was tatsächlich verkauft wird
Ich will den Fehlschlag präzise benennen, nicht auf ihn deuten, deshalb hier die Form der Sache.
Ein großer Teil des KI-Marktes für Unternehmen besteht aus Produkten, die ein Frontier-Modell in ein Chat-Fenster packen, Retrieval über einen Dokumentenspeicher hinzufügen und das Ergebnis als KI-Plattform beschreiben. Diese Produkte demonstrieren wunderbar. Sie bewältigen die zwanzig Fragen, die ein Käufer in einem Workshop stellt. Sie scheitern an denen, die im vierten Monat kommen - die Abfrage, die drei Sprünge über zwei Quellsysteme braucht, die Antwort, die eine Klausel zitieren und eine Prüfung überstehen muss, der Ablauf, der zweimal dasselbe Ergebnis liefern muss, das Retrieval, das eine Zugriffskontrollliste respektieren muss, die in einem anderen System liegt als der Index.
Und weil der Markt den Unterschied zum Zeitpunkt des Kaufs nicht leicht erkennen kann, werden die Anbieter für die Lücke nicht bestraft. Sie werden fürs Aufräumen belohnt.
Eine gut aufgenommene Ankündigung im Bereich der Agentenplattformen hat kürzlich automatische Archivierung eingeführt: Agenten, die eine Weile niemand benutzt hat, verschwinden aus der Arbeitsliste, damit die, auf die sich die Leute verlassen, leichter zu finden sind. Das ist vernünftige Pflege. Es ist auch die Einführung einer Funktion, deren Daseinszweck darin besteht, die Symptome einer Architektur zu bewältigen, die das eigentliche Problem nie angefasst hat: den Grund herauszufinden, warum der Agent nicht benutzt wird, statt ihn stillschweigend aus dem Weg zu räumen. Wenn die Plattform wüsste, was jeder Agent leisten soll und wo er scheitert, wäre Archivierung kein Feature, sondern ein Diagnosebefund. Hinter der Archivierung verbirgt sich ein Friedhof, den die Architektur immer weiter füllen wird. [⁵] Und die Begeisterung des Marktes ist eher ein Indikator als das eigentliche Produkt: Wenn das Aufräumen der Liste als Hauptfunktion angepriesen wird, können Käufer noch nicht zwischen Substanz und Verpackung unterscheiden. Deshalb stagnieren die Gewinnzahlen, während die Wissenschaft jahrhundertealte Probleme löst.
Was seriöse industrielle KI tatsächlich aussieht
Hier ist der Teil, der mir am wichtigsten ist, weil die Lücke hier am größten ist und die Forschungsgemeinschaft die Arbeit bereits geleistet hat.
Das Modell macht nicht das Engineering. Das ist der Punkt, den fast jedes KI-Produkt für Unternehmen falsch versteht, und der Navier-Stokes-Fall zeigt es perfekt: Das Modell hat den Beweis nicht verifiziert. Lean hat den Beweis verifiziert. Das Modell hat geplant, erkundet, zerlegt und vorgeschlagen; ein deterministisches System hat festgestellt, was wahr ist.
Übertragen Sie dieses Muster auf das industrielle Engineering, und die Architektur wird offensichtlich. Es gibt dreißig Jahre erstklassige quelloffene wissenschaftliche und Engineering-Software - Berechnungsgeometrie-Kernel, Finite-Elemente- und CFD-Löser, Netzgeneratoren, Constraint-Solver, Optimierer, Formatbibliotheken für jeden industriellen Austauschstandard. Gebaut von der Forschungsgemeinschaft, über Jahrzehnte validiert, frei verfügbar und fast vollständig ungenutzt in Unternehmen, weil ihre Bedienung Fachwissen erfordert, das nicht skaliert.
Das ist die eigentliche Chance. Kein Modell, das vorgibt, Aerodynamik zu verstehen, sondern eine Orchestrierungsschicht, die den Fall aufsetzen, den etablierten Löser ansteuern, das Ergebnis lesen, entscheiden kann, was zu ändern ist, und iterieren - wobei jeder Schritt aufgezeichnet und jede Behauptung prüfbar ist. Die Intelligenz liegt in der Planung und der Interpretation. Die Wahrheit kommt von den Werkzeugen.
Zwei Beispiele aus unserer eigenen Arbeit.
Das erste ist die Dokumentation der Verfahrenstechnik, was mein eigener Hintergrund ist. Ein Rohrleitungs- und Instrumentierungsdiagramm (R&I-Fließbild) ist die kanonische Beschreibung einer Prozessanlage: Apparate, Leitungen, Instrumente, Regelkreise, Ventile, Sollwerte, Anschlusspunkte, alles versehen mit Kennzeichnungen, die über Zeichnungen, Apparatelisten, Ursache-Wirkungs-Matrizen und Revisionshistorien hinweg übereinstimmen müssen. Einen Satz davon zu analysieren ist ein Graphenproblem im Kostüm einer Zeichnung, und es richtig zu machen bedeutet, die Struktur aus Dokumenten zu extrahieren, die häufig Scans sind, Kennzeichnungen über Revisionen und Dokumenttypen hinweg abzugleichen, Regelkreise durchgehend zu verfolgen und zu identifizieren, was fehlt, verwaist oder inkonsistent ist.
Der Mechanismus, der das handhabbar macht, ist kein besseres Modell. Es ist multimodale Erfassung, die Zeichnungen als Zeichnungen behandelt; eine Ontologie, die weiß, was ein Apparat, eine Leitung, ein Instrument und ein Regelkreis sind und wie sie zusammenhängen, sodass eine Kennzeichnung in einem Dokument und dieselbe Kennzeichnung in einem anderen als dieselbe Entität erkannt werden; deterministische Prüfungen, die über den extrahierten Graphen laufen, sodass ein Konsistenzbefund ein berechnetes Faktum ist und kein Eindruck eines Modells; agentische Threads für den mehrstufigen Abgleich, den keine einzelne Abfrage ausdrücken kann; und ein Nachvollziehbarkeitsprotokoll, damit ein Ingenieur sehen kann, warum jeder Befund ausgelöst wurde, und ihn anhand der Evidenz ablehnen kann. Das Modell liest und vergleicht. Die deterministische Schicht entscheidet, was als Mangel gilt. Ein Ingenieur entscheidet, was wichtig ist.
Das zweite ist Geometrie, und ich kann es zeigen. Unser Forschungsteam hat eine interne Übung an der Karosserie eines Le Mans Hypercar durchgeführt - bewusst gewählt, weil die Regularien öffentlich sind, die geometrischen Randbedingungen unnachgiebig sind und die Arbeit entweder stimmt oder nicht.
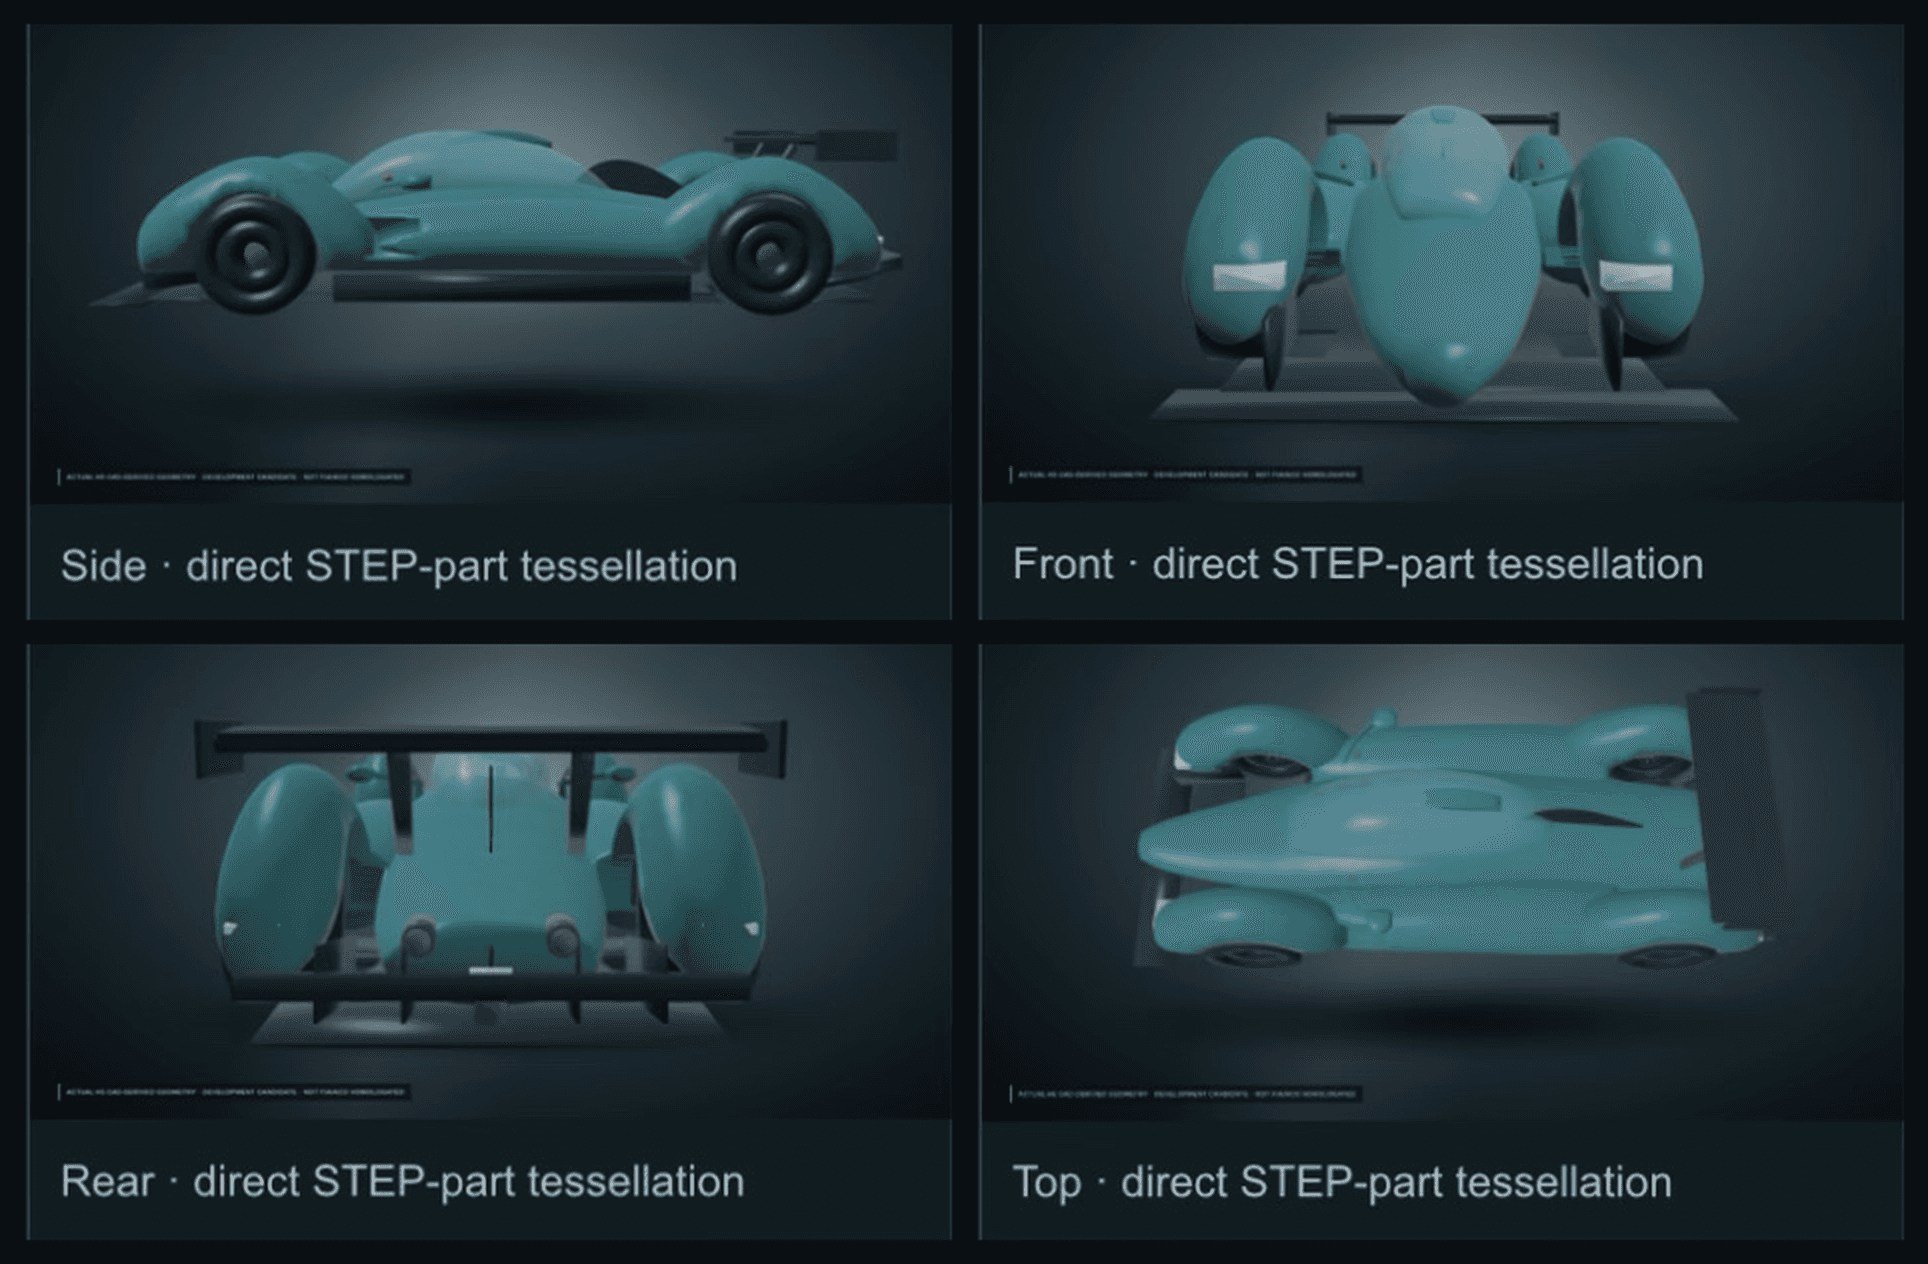
Vier Ansichten, direkt aus den STEP-Bauteilen tesselliert. Renders sind billig; der Punkt ist, was dahinter sitzt.
Wichtig ist nicht, dass ein ansprechend aussehendes Auto erschienen ist. Alles kann ein ansprechend aussehendes Auto erzeugen. Wichtig ist, dass das Ergebnis ein exaktgeometrischer Master mit einem angehängten Evidenzpaket ist.
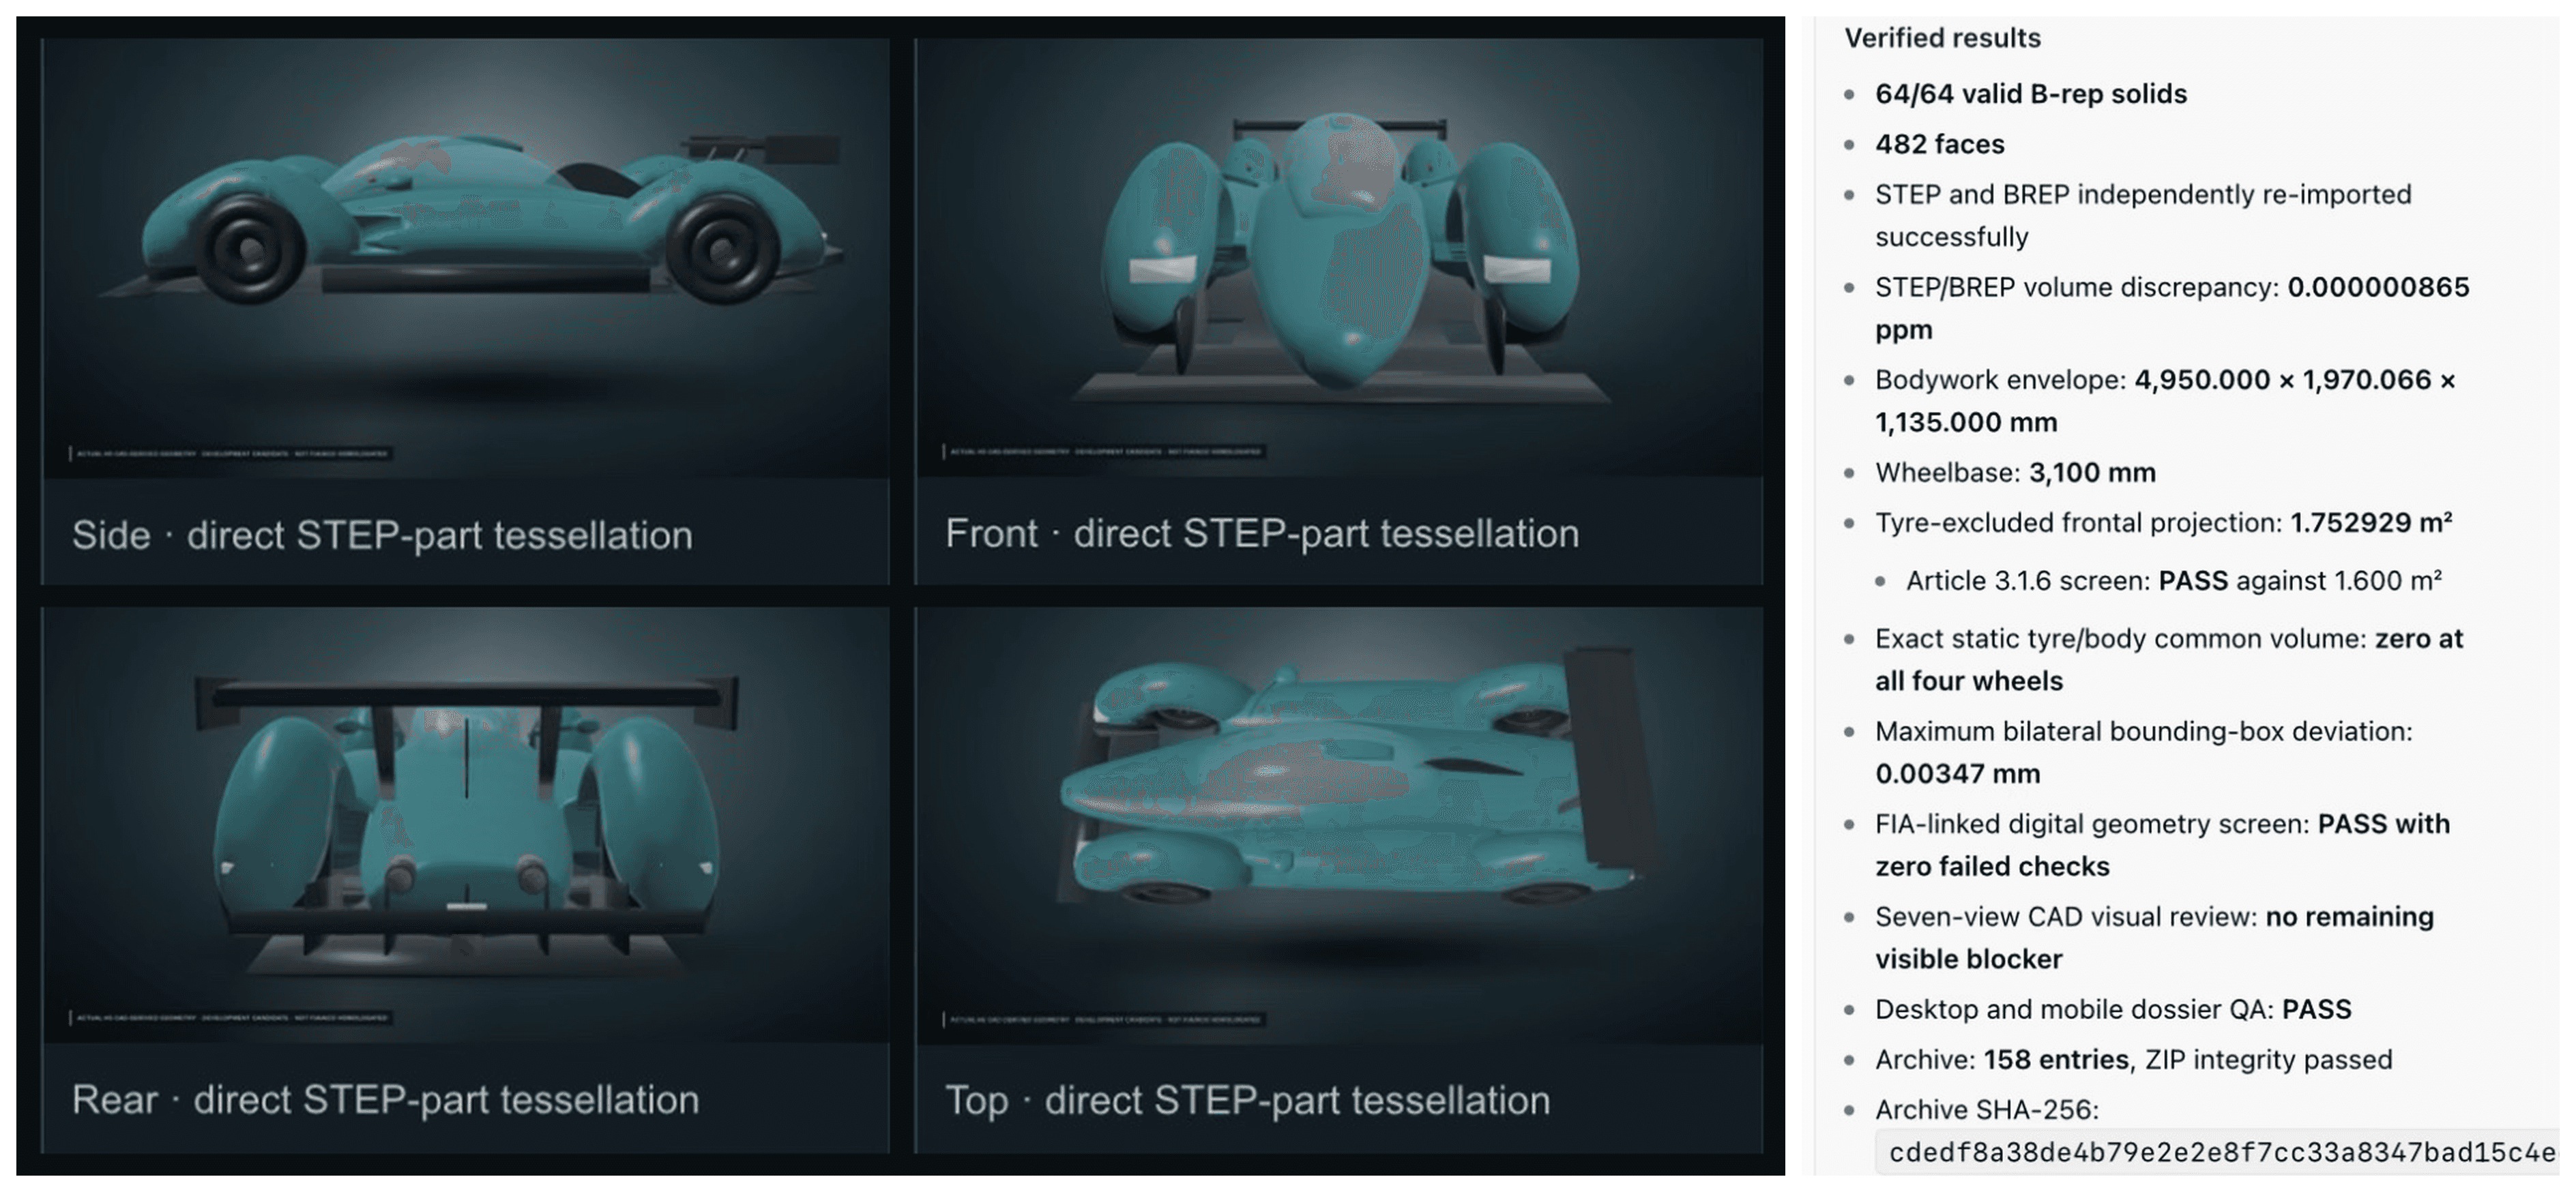
Die Geometrie neben ihrem Verifizierungsprotokoll. Jede Abbildung auf der rechten Seite wurde mithilfe von Open-Source-Software für computergestützte Geometrie berechnet und nicht von einem Sprachmodell generiert.
Vierundsechzig von vierundsechzig gültigen B-Rep-Volumenkörpern.
STEP- und native BREP-Master, die beide unabhängig voneinander reimportierbar sind mit einer Volumendiskrepanz zwischen den beiden Darstellungen von unter einem Milliardstel.
Karosserieumhüllende und Radstand auf den Millimeter.
Reifenausgeschlossene Frontalprojektion berechnet mit 1,752929 m2 und geprüft gegen die Schwelle des Reglements von 1,600 m2.
Exaktes statisches Reifen-Karosserie-Überschneidungsvolumen von null an allen vier Rädern.
Maximale bilaterale Bounding-Box-Abweichung von 0,00347 mm.
Ein reglementsgebundener Geometrie-Screen, der mit null fehlgeschlagenen Prüfungen besteht.
Ein Archiv mit 158 Einträgen mit einem SHA-256-Hash über das Ganze.
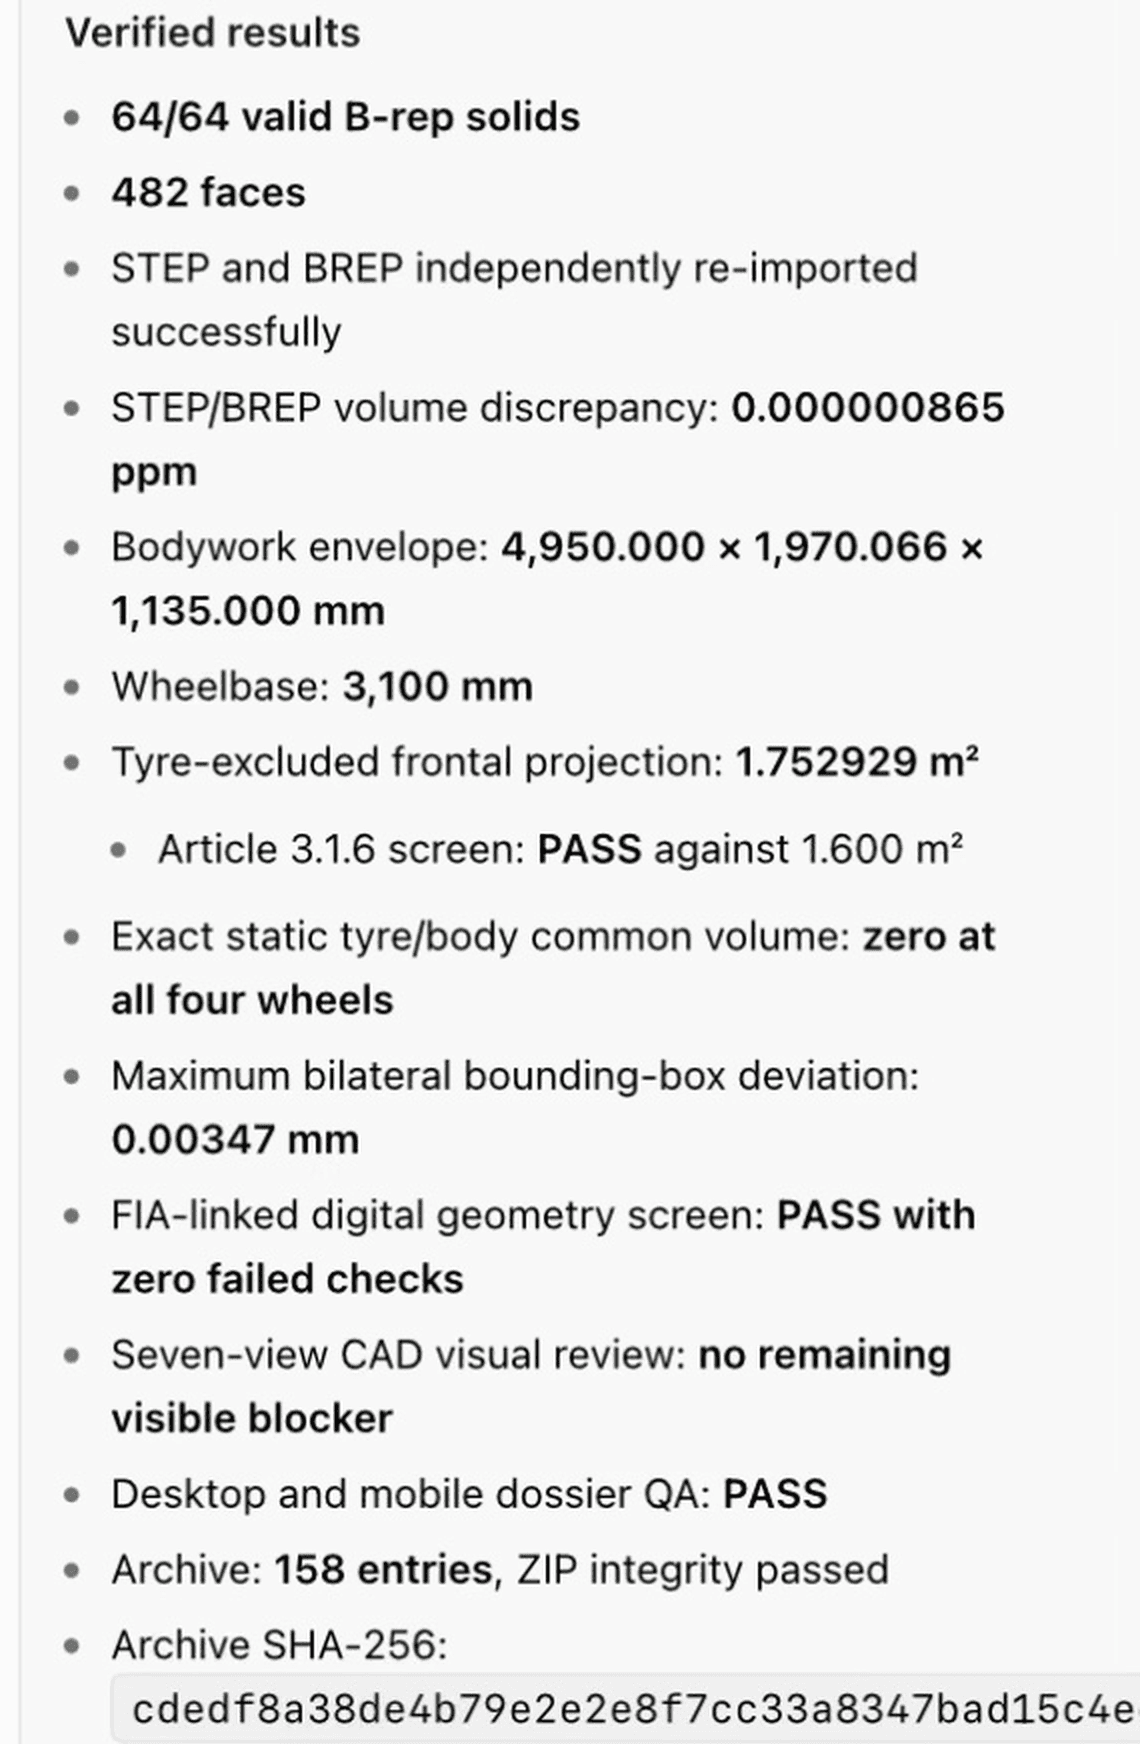
Prüfprotokoll für das Geometrie-Referenzmodell.
Jede dieser Zahlen ist ein berechneter Wert, erzeugt von quelloffener Berechnungsgeometrie, nicht eine Behauptung eines Sprachmodells. Das Modell hat den Prozess gesteuert; der Kernel hat die Fakten festgestellt. Das ist dieselbe Arbeitsteilung wie beim Lean-Beweis, angewandt auf ein industrielles Artefakt - und es ist das, was das Ergebnis zu etwas macht, mit dem ein Ingenieur diskutieren kann, statt etwas, dem ein Käufer vertrauen muss.
Und die ehrliche Grenze, so klar ausgesprochen wie intern: Dies ist ein Vorzertifizierungs-Master. Er ist messbar, reimportierbar und unabhängig prüfbar. Er ist nicht FIA- oder ACO-homologiert, nicht freigegeben und nicht fertigungsfähig. Wer Ihnen erzählt, ein Sprachmodell habe ein homologiertes Rennauto hervorgebracht, verkauft Ihnen etwas. Was hervorgebracht wurde, ist ein rigoroser, prüfbarer Ausgangspunkt, der eine enorme Menge der Geometriearbeit beseitigt, die normalerweise der zertifizierbaren Designrunde vorausgeht - und die die nächste Runde dann verdienen muss.
Das ist interne Forschung, kein ausgeliefertes Produkt, obwohl Kunden begonnen haben, eigene Arbeiten darüber laufen zu lassen. Ich sage das lieber, als das Gegenteil zu implizieren.
Wo neuland.ai steht
Der Grund, warum wir das können, ist nicht, dass wir ein besseres Modell haben. Wir haben kein Modell. Es liegt daran, dass die Plattform um die fünf Eigenschaften herum gebaut wurde, die der Mathematik-Fall aufzeigt, weil diese Eigenschaften dieselben sind, die seriöse industrielle Ingenieursarbeit erfordert. [⁶]
Routing über verschiedene Modelle hinweg je nach Workload, ausgewählt nach Leistungsfähigkeit, Kosten, Standort und Richtlinien – und nicht danach, wessen Inferenz wir verkaufen, denn wir verkaufen gar keine. Eine Ontologie, die die kundeneigene Domäne abbildet: Was eine Entität in dessen Werk, dessen Flotte oder dessen Portfolio ist und wie diese Entitäten miteinander in Beziehung stehen. Eine Orchestrierung, die deterministisch ist, wenn ein Ergebnis reproduzierbar sein muss, und agentisch, wenn der Pfad nicht im Voraus aufgezählt werden kann, wobei die Entscheidung pro Aufgabe getroffen wird. Eine Ausführung, die echte Engineering-Tools innerhalb einer Sandbox antreiben kann, anstatt nur zu beschreiben, was solche Tools ausgeben würden. Verifizierung als Schritt erster Ordnung, sodass eine Behauptung durch etwas anderes überprüft wird als durch das Modell, das sie erstellt hat. Und ein ausschließlich nachträglich ergänzbares Protokoll über jeden Abruf, jede Entscheidung und jeden Tool-Aufruf, damit ein Ergebnis auch Monate später noch bis zu seinen Belegen zurückverfolgt werden kann.
Diese Liste ist kein Feature-Vergleich. Sie ist die Antwort auf die Frage, warum ein Sprachmodell helfen kann, ein Millenniumsproblem zu lösen, und es allein nicht schafft, Ihnen zu sagen, ob Ihr R&I-Satz intern konsistent ist.
Persönliche Einschätzung
Ich bin in dieser Serie über zweiundzwanzig Beiträge gemessen worden, also will ich einmal deutlich sein.
Enterprise KI bleibt nicht hinter den Erwartungen zurück, weil die Technologie unreif ist. Im selben Monat, in dem die Ertragszahlen zum zweiten Mal in Folge flach hereinkamen, hat ein Multi-Agenten-System ein Problem geschlossen, an dem Mathematiker seit 1934 gescheitert waren, und Open-Weight-Modelle haben die Frontier zu einem Vierzigstel der Kosten des Vorjahres erreicht. Die Technologie ist außergewöhnlich und sie ist billig.
Enterprise KI bleibt hinter den Erwartungen zurück, weil ein großer Anteil des Geldes in Produkte geflossen ist, die nie hätten funktionieren können, gekauft von Menschen, die keine Möglichkeit hatten, das zu erkennen, von Anbietern, die nicht verpflichtet waren zu erklären, wie irgendetwas funktioniert. Das Ergebnis ist eine branchenweite Verknüpfung der Worte Unternehmens-KI und enttäuschendes Pilotprojekt, die jetzt die Organisationen aktiv zurückhält, die am meisten profitieren würden - die Industrieunternehmen, die Ingenieurbüros, die regulierten Institutionen mit vierzig Jahren angesammeltem Prozesswissen und einem echten Bedarf an Systemen, die darüber nachdenken können.
Diesen Organisationen wurde, durch ihre eigene Erfahrung, gesagt, dass diese Technologie nicht liefert. Was ihnen tatsächlich gesagt wurde, ist, dass eine Chat-Oberfläche über einem Dokumentenspeicher nicht liefert, was schon immer wahr war und was die Forschungsgemeinschaft ihnen umsonst hätte sagen können.
Die Lücke zwischen der Mathematik und der Gewinn-und-Verlust-Rechnung ist keine Lücke in der Fähigkeit. Es ist eine Lücke in der Architektur, und sie wird sich schließen für die Organisationen, die anfangen, Anbieter zu fragen, wie Dinge funktionieren, statt was sie in einer Demo können. Die Werkzeuge, die die Forschungsgemeinschaft über drei Jahrzehnte gebaut hat, liegen da, frei, validiert und darauf wartend, dass jemand sie richtig bedient.
Wir lassen uns lieber an einem Geometriepaket mit einer Hash-Prüfsumme messen als an einer Demo.
Eine kurze Anmerkung zum regulatorischen Hintergrund, da er sich weiterentwickelt. Der EU AI Act wurde am 2. August 2026 in weiten Teilen anwendbar, mit GPAI-Durchsetzungsbefugnissen nach Kapitel V ab diesem Datum; die Digital-Omnibus-Einigung vom 7. Mai 2026 verschob die Hochrisiko-Verpflichtungen nach Annex III auf den 2. Dezember 2027 und die Annex-I-Verpflichtungen auf den 2. August 2028. [⁷] Relevant hier: Eine Architektur, in der Behauptungen durch deterministische Werkzeuge aufgestellt und gegen Evidenz festgehalten werden, ist unter diesem Regime dramatisch leichter zu dokumentieren als eine, in der die Antwort das ist, was das Modell gesagt hat. Der Compliance-Fall und der Engineering-Fall sind derselbe Fall.
Die Theoreme fallen. Die Lücke ist nicht die Technologie. Das ist die Arbeit, die vor uns liegt, und es ist die Arbeit, die wir machen.
Beiträge der Serie unter neuland.ai/en/resources/insights.
Ankündigung von OpenAI vom 8. September 2026 zum Navier-Stokes-Existenz- und Glattheitsproblem, einem der sieben Millennium-Probleme des Clay Mathematics Institute aus dem Jahr 2000. Berichtete Architektur: ein Multi-Agenten-System, koordiniert von einem unveröffentlichten internen Modell, zeitweise mit rund zehntausend parallel laufenden Sub-Agenten, über ungefähr achtundachtzig Stunden, mit einer vereinfachten Fassung der Frage, die zuvor in ungefähr fünfzig Stunden mit rund tausend Agenten beantwortet wurde; Beweis veröffentlicht mit einer Formalisierung in Lean. Prioritätsstreit: Tristan Buckmaster (Courant Institute, NYU) und Levent Alpöge (Harvard) hatten rund ein Jahr an dem Problem gearbeitet, aufbauend auf einem Ansatz von Córdoba und Martínez-Zoroa, am 15. August 2026 Blow-up für die Euler-Gleichungen bewiesen unter Verwendung von Modellen von Anthropic und OpenAI und das Ergebnis in Lean verifiziert, und ihr Ergebnis zum reibungsfreien Fall am 7. September 2026 veröffentlicht mit der Erklärung, eine Lösung des allgemeineren Problems werde folgen. OpenAI hat erklärt, seine Ressourcen am 1. September 2026 auf das Problem gerichtet zu haben, nachdem Gerüchte über diese Arbeit aufgekommen waren. Buckmaster hat öffentlich einen Versuch der Vereinnahmung der Entdeckung vorgeworfen. Buckmasters Darstellung vermerkt auch, dass die natürlichsprachliche Erklärung der Modelle kaum lesbar war und die Schritte für andere Forscher manuell rekonstruiert werden mussten. Berichterstattung: Nature, Fortune, Scientific American, 8.-9. September 2026. Dieser Beitrag bezieht keine Position in der Prioritätsfrage.
McKinsey, State of AI, veröffentlicht 25. August 2026; 1.719 Befragte aus 97 Ländern, erhoben 4. Mai bis 8. Juni 2026, gewichtet nach dem BIP-Anteil jedes Landes. Referenzierte Ergebnisse: 80 Prozent berichten von individuellen Produktivitätsgewinnen gegenüber 37 Prozent mit irgendeiner EBIT-Auswirkung, letztere im Jahresvergleich unverändert; ungefähr 6 Prozent schreiben 5 Prozent oder mehr ihres EBIT der KI zu, ebenfalls unverändert; 32 Prozent lehnten mindestens einen Softwarekauf ab, weil agentische Coding-Werkzeuge internen Bau ermöglichten, mit Branchenvariation von ungefähr 41 Prozent im Technologiesektor bis 19 Prozent in der Versicherungsbranche und 17 Prozent im öffentlichen Sektor; große Unternehmen, die Agenten in einer oder mehreren Funktionen skalieren, stiegen von 27 auf 40 Prozent, während kleinere Organisationen bei 22 Prozent verharrten; 20 Prozent berichten, dass KI-Betriebskosten einschließlich Token-Kosten ihren KI-Einsatz eingeschränkt haben.
Gartner-CIO-Umfragedaten, wonach ungefähr 17 Prozent der Organisationen KI-Agenten eingesetzt haben; Deloitte Tech Trends 2026 setzt produktionsreife agentische Systeme bei ungefähr 11 Prozent an.
Siehe frühere Beiträge dieser Serie mit dem Argument, dass die sinnvolle Einheit das definierte Ergebnis ist und nicht der manuell konstruierte Ablauf, und dass eine Plattform die kontrollierte Grundlage bereitstellen sollte, auf der ein Agent läuft, statt zu versuchen, der Agent zu sein.
Zu den referenzierten Architektureigenschaften und dem Argument, dass sie zum Zeitpunkt des Entwurfs entschieden werden und nicht nachträglich hinzugefügt werden können, siehe den früheren Beitrag dieser Serie mit der Definition einer KI-Orchestrierungs- und -Management-Plattform für Unternehmen.
Rat der EU und Europäisches Parlament, vorläufige politische Einigung zum Digital Omnibus zur KI, 7. Mai 2026: Hochrisiko-Verpflichtungen nach Annex III verschoben auf 2. Dezember 2027; Annex-I-Verpflichtungen verschoben auf 2. August 2028; Wasserzeichenverpflichtungen nach Artikel 50(2) verschoben auf 2. Dezember 2026. GPAI-Durchsetzungsbefugnisse nach Kapitel V verbindlich ab 2. August 2026.
Am 8. September 2026 gab OpenAI bekannt, dass ein unveröffentlichtes internes Modell eine Lösung für das Navier-Stokes-Existenz- und Glattheitsproblem hervorgebracht hatte - eines der sieben Millennium-Probleme, die das Clay Mathematics Institute im Jahr 2000 ausgeschrieben hat. Das System lief als Multi-Agenten-Architektur, die zeitweise zehntausend Sub-Agenten an verschiedenen Teilen und Varianten des Problems arbeiten ließ, achtundachtzig Stunden benötigte und einen Beweis in Lean erzeugte, der formalen Verifikationssprache, sodass das Argument von einem Kernel geprüft werden konnte, statt auf Behauptung hin geglaubt werden zu müssen. Zwei Wochen zuvor, am 25. August, hatte McKinsey seine State-of-AI-Umfrage veröffentlicht: 1.719 Befragte aus 97 Ländern, erhoben von Mai bis Anfang Juni. Achtzig Prozent der Organisationen berichten von individuellen Produktivitätsgewinnen durch KI. Siebenunddreißig Prozent berichten von irgendeiner Auswirkung auf das Ergebnis. Diese zweite Zahl ist gegenüber dem Vorjahr unverändert. Der Anteil der Befragten, die fünf Prozent oder mehr ihres EBIT auf KI zurückführen, liegt bei ungefähr sechs Prozent, und auch er hat sich nicht bewegt. In derselben Vierzehntagesspanne hat also künstliche Intelligenz ein Problem geschlossen, das seit 1934 offen war, und es im zweiten Jahr in Folge nicht geschafft, das Ergebnis der Unternehmen zu bewegen, die dafür bezahlen. Die bequeme Lesart ist, dass die Forschung der Praxis voraus ist und die Unternehmen aufholen werden. Ich halte diese Lesart für falsch, und ich halte sie für teuer. Die Wissenschaft funktioniert nicht, weil die Modelle besser sind als die, die Unternehmen haben. Sie funktioniert, weil die Systeme, die um diese Modelle herum gebaut wurden, Eigenschaften haben, die fast nichts besitzt, was in den Unternehmensmarkt verkauft wird. Und der Grund, warum Unternehmen den Unterschied nicht erkennen können, ist, dass der Markt aufgehört hat, Tiefe zu belohnen - so weit, dass eine gut aufgenommene Ankündigung einer Agentenplattform in dieser Saison die automatische Archivierung der Agenten war, die niemand nutzt, eine sinnvolle Aufräumfunktion, die den Grund, warum sie ungenutzt sind, vollständig unberührt lässt.
Dies ist der dreiundzwanzigste Beitrag einer Serie, die ich für neuland.ai schreibe. [¹] Er ist direkter als die vorangegangenen zweiundzwanzig, weil ich ein Jahr lang strukturell argumentiert habe und die Zahlen das strukturelle Argument jetzt dringend gemacht haben.
Was in der Mathematik tatsächlich passiert ist
Die Navier-Stokes-Ankündigung kam inmitten eines Prioritätsstreits, und der Streit ist es wert, verstanden statt übersprungen zu werden, weil die ehrliche Fassung der Geschichte lehrreicher ist als die Pressemitteilung.
Tristan Buckmaster vom Courant Institute der NYU und Levent Alpöge von Harvard hatten rund ein Jahr an dem Problem gearbeitet, aufbauend auf einem Ansatz von Córdoba und Martínez-Zoroa. Am 15. August bewiesen sie, dass die Euler-Gleichungen - die reibungsfreie Vereinfachung von Navier-Stokes - tatsächlich aufblasen, unter Verwendung von Modellen von Anthropic und OpenAI, und verifizierten das Ergebnis in Lean. Am 7. September veröffentlichten sie dieses Ergebnis und erklärten, sie hätten eine Lösung des allgemeineren Problems erhalten. OpenAI richtete nach eigener Darstellung am 1. September seine Ressourcen auf Navier-Stokes, nachdem Gerüchte über deren Arbeit aufgekommen waren, und gab am 8. September seine Ankündigung heraus. Buckmaster hat OpenAI öffentlich vorgeworfen, die Entdeckung vereinnahmen zu wollen. [²]
Ich bin nicht in der Position, das zu beurteilen, und ich werde es nicht versuchen. Was hier zählt, ist das, worüber beide Darstellungen übereinstimmen, und es ist die Beschreibung einer Architektur, nicht eines Modells.
Es gab tiefe fachliche Verankerung. Ein Jahr Expertenarbeit, innerhalb eines spezifischen mathematischen Rahmens, von Menschen, die verstanden, welche Angriffslinien plausibel waren. Die Modelle haben nicht entschieden, was versucht werden soll.
Es gab modellagnostische Orchestrierung. Modelle von mindestens zwei konkurrierenden Anbietern wurden eingesetzt, gewählt pro Teilproblem. Niemand, der beteiligt war, hat sich darum geschert, wessen Logo auf der Inferenz stand.
Es gab einen deterministischen Verifikationsschritt. Dem Beweis wird vertraut, weil Leans Kernel ihn geprüft hat. Nicht weil ein Modell ihn behauptet hat, nicht weil ein Gutachter ihn überzeugend fand, und nicht weil er flüssig zu lesen war - was wichtig ist, weil der Beweis nach Buckmasters Darstellung in natürlicher Sprache kaum lesbar war und die Schritte für andere Forscher manuell rekonstruiert werden mussten.
Es gab eine massive parallele Zerlegung mit dauerhaftem Zustand. Tausende von Unteragenten in einem Aufgabengraf, die tagelang liefen, wobei sich die Ergebnisse ansammelten, anstatt zu verfliegen.
Und an der Schnittstelle kam Expertenurteil zum Tragen. Menschen entschieden, was die Ausgabe bedeutete, und machten sie verständlich.
Fünf Eigenschaften. Und jetzt halten Sie diese Liste neben das, woraus ein typischer KI-Einsatz im Unternehmen besteht: eine Chat-Oberfläche, ein Vektorspeicher, ein System-Prompt und ein Abonnement.
Warum die McKinsey-Zahlen stimmen und die Interpretation falsch ist
Die Umfrage misst nicht eine Technologie, die nicht funktioniert. Sie misst den Einsatz von etwas, das nie gebaut wurde, um zu funktionieren.
Sehen Sie sich an, was derselbe Bericht noch fand. Zweiunddreißig Prozent der Organisationen lehnten mindestens einen Softwarekauf ab, weil agentische Coding-Werkzeuge es ihnen ermöglichten, selbst zu bauen. Große Unternehmen, die Agenten in einer oder mehreren Funktionen skalieren, stiegen in einem Jahr von siebenundzwanzig auf vierzig Prozent, während kleinere Organisationen bei zweiundzwanzig stehen blieben. Zwanzig Prozent berichten, dass KI-Betriebskosten, einschließlich Token-Kosten, ihren Einsatz von KI bereits eingeschränkt haben. [³]
Liest man diese Zahlen zusammen, ergibt sich kein Bild einer Technologie, die nicht liefert. Es ist das Bild eines Marktes, in dem die Fähigkeit real ist, konzentriert in Organisationen, die Plattform- und Governance-Kapazität haben, teuer im Betrieb und größtenteils als Produktivitätswerkzeug eingesetzt statt als Engineering-Fähigkeit. Achtzig Prozent fühlen sich schneller. Siebenunddreißig Prozent finden es in den Büchern. Diese Lücke ist genau das, was man vorhersagen würde, wenn ein großer Anteil der KI-Ausgaben im Unternehmen auf Oberflächen statt auf Systeme gegangen wäre.
Unabhängige Zahlen weisen in dieselbe Richtung. Gartner kommt auf rund siebzehn Prozent der Organisationen, die tatsächlich Agenten eingesetzt haben. Deloitte setzt produktionsreife agentische Systeme bei ungefähr elf Prozent an. [⁴] Niemand scheitert an der Einführung, weil die Modelle unzureichend wären. GLM, Kimi, Claude, GPT und ihre Open-Weight-Pendants sind alle, an diesem Punkt, zu weit mehr fähig als die meisten Unternehmen von ihnen verlangen.
Was tatsächlich verkauft wird
Ich will den Fehlschlag präzise benennen, nicht auf ihn deuten, deshalb hier die Form der Sache.
Ein großer Teil des KI-Marktes für Unternehmen besteht aus Produkten, die ein Frontier-Modell in ein Chat-Fenster packen, Retrieval über einen Dokumentenspeicher hinzufügen und das Ergebnis als KI-Plattform beschreiben. Diese Produkte demonstrieren wunderbar. Sie bewältigen die zwanzig Fragen, die ein Käufer in einem Workshop stellt. Sie scheitern an denen, die im vierten Monat kommen - die Abfrage, die drei Sprünge über zwei Quellsysteme braucht, die Antwort, die eine Klausel zitieren und eine Prüfung überstehen muss, der Ablauf, der zweimal dasselbe Ergebnis liefern muss, das Retrieval, das eine Zugriffskontrollliste respektieren muss, die in einem anderen System liegt als der Index.
Und weil der Markt den Unterschied zum Zeitpunkt des Kaufs nicht leicht erkennen kann, werden die Anbieter für die Lücke nicht bestraft. Sie werden fürs Aufräumen belohnt.
Eine gut aufgenommene Ankündigung im Bereich der Agentenplattformen hat kürzlich automatische Archivierung eingeführt: Agenten, die eine Weile niemand benutzt hat, verschwinden aus der Arbeitsliste, damit die, auf die sich die Leute verlassen, leichter zu finden sind. Das ist vernünftige Pflege. Es ist auch die Einführung einer Funktion, deren Daseinszweck darin besteht, die Symptome einer Architektur zu bewältigen, die das eigentliche Problem nie angefasst hat: den Grund herauszufinden, warum der Agent nicht benutzt wird, statt ihn stillschweigend aus dem Weg zu räumen. Wenn die Plattform wüsste, was jeder Agent leisten soll und wo er scheitert, wäre Archivierung kein Feature, sondern ein Diagnosebefund. Hinter der Archivierung verbirgt sich ein Friedhof, den die Architektur immer weiter füllen wird. [⁵] Und die Begeisterung des Marktes ist eher ein Indikator als das eigentliche Produkt: Wenn das Aufräumen der Liste als Hauptfunktion angepriesen wird, können Käufer noch nicht zwischen Substanz und Verpackung unterscheiden. Deshalb stagnieren die Gewinnzahlen, während die Wissenschaft jahrhundertealte Probleme löst.
Was seriöse industrielle KI tatsächlich aussieht
Hier ist der Teil, der mir am wichtigsten ist, weil die Lücke hier am größten ist und die Forschungsgemeinschaft die Arbeit bereits geleistet hat.
Das Modell macht nicht das Engineering. Das ist der Punkt, den fast jedes KI-Produkt für Unternehmen falsch versteht, und der Navier-Stokes-Fall zeigt es perfekt: Das Modell hat den Beweis nicht verifiziert. Lean hat den Beweis verifiziert. Das Modell hat geplant, erkundet, zerlegt und vorgeschlagen; ein deterministisches System hat festgestellt, was wahr ist.
Übertragen Sie dieses Muster auf das industrielle Engineering, und die Architektur wird offensichtlich. Es gibt dreißig Jahre erstklassige quelloffene wissenschaftliche und Engineering-Software - Berechnungsgeometrie-Kernel, Finite-Elemente- und CFD-Löser, Netzgeneratoren, Constraint-Solver, Optimierer, Formatbibliotheken für jeden industriellen Austauschstandard. Gebaut von der Forschungsgemeinschaft, über Jahrzehnte validiert, frei verfügbar und fast vollständig ungenutzt in Unternehmen, weil ihre Bedienung Fachwissen erfordert, das nicht skaliert.
Das ist die eigentliche Chance. Kein Modell, das vorgibt, Aerodynamik zu verstehen, sondern eine Orchestrierungsschicht, die den Fall aufsetzen, den etablierten Löser ansteuern, das Ergebnis lesen, entscheiden kann, was zu ändern ist, und iterieren - wobei jeder Schritt aufgezeichnet und jede Behauptung prüfbar ist. Die Intelligenz liegt in der Planung und der Interpretation. Die Wahrheit kommt von den Werkzeugen.
Zwei Beispiele aus unserer eigenen Arbeit.
Das erste ist die Dokumentation der Verfahrenstechnik, was mein eigener Hintergrund ist. Ein Rohrleitungs- und Instrumentierungsdiagramm (R&I-Fließbild) ist die kanonische Beschreibung einer Prozessanlage: Apparate, Leitungen, Instrumente, Regelkreise, Ventile, Sollwerte, Anschlusspunkte, alles versehen mit Kennzeichnungen, die über Zeichnungen, Apparatelisten, Ursache-Wirkungs-Matrizen und Revisionshistorien hinweg übereinstimmen müssen. Einen Satz davon zu analysieren ist ein Graphenproblem im Kostüm einer Zeichnung, und es richtig zu machen bedeutet, die Struktur aus Dokumenten zu extrahieren, die häufig Scans sind, Kennzeichnungen über Revisionen und Dokumenttypen hinweg abzugleichen, Regelkreise durchgehend zu verfolgen und zu identifizieren, was fehlt, verwaist oder inkonsistent ist.
Der Mechanismus, der das handhabbar macht, ist kein besseres Modell. Es ist multimodale Erfassung, die Zeichnungen als Zeichnungen behandelt; eine Ontologie, die weiß, was ein Apparat, eine Leitung, ein Instrument und ein Regelkreis sind und wie sie zusammenhängen, sodass eine Kennzeichnung in einem Dokument und dieselbe Kennzeichnung in einem anderen als dieselbe Entität erkannt werden; deterministische Prüfungen, die über den extrahierten Graphen laufen, sodass ein Konsistenzbefund ein berechnetes Faktum ist und kein Eindruck eines Modells; agentische Threads für den mehrstufigen Abgleich, den keine einzelne Abfrage ausdrücken kann; und ein Nachvollziehbarkeitsprotokoll, damit ein Ingenieur sehen kann, warum jeder Befund ausgelöst wurde, und ihn anhand der Evidenz ablehnen kann. Das Modell liest und vergleicht. Die deterministische Schicht entscheidet, was als Mangel gilt. Ein Ingenieur entscheidet, was wichtig ist.
Das zweite ist Geometrie, und ich kann es zeigen. Unser Forschungsteam hat eine interne Übung an der Karosserie eines Le Mans Hypercar durchgeführt - bewusst gewählt, weil die Regularien öffentlich sind, die geometrischen Randbedingungen unnachgiebig sind und die Arbeit entweder stimmt oder nicht.
Vier Ansichten, direkt aus den STEP-Bauteilen tesselliert. Renders sind billig; der Punkt ist, was dahinter sitzt.
Wichtig ist nicht, dass ein ansprechend aussehendes Auto erschienen ist. Alles kann ein ansprechend aussehendes Auto erzeugen. Wichtig ist, dass das Ergebnis ein exaktgeometrischer Master mit einem angehängten Evidenzpaket ist.
Die Geometrie neben ihrem Verifizierungsprotokoll. Jede Abbildung auf der rechten Seite wurde mithilfe von Open-Source-Software für computergestützte Geometrie berechnet und nicht von einem Sprachmodell generiert.
Vierundsechzig von vierundsechzig gültigen B-Rep-Volumenkörpern.
STEP- und native BREP-Master, die beide unabhängig voneinander reimportierbar sind mit einer Volumendiskrepanz zwischen den beiden Darstellungen von unter einem Milliardstel.
Karosserieumhüllende und Radstand auf den Millimeter.
Reifenausgeschlossene Frontalprojektion berechnet mit 1,752929 m2 und geprüft gegen die Schwelle des Reglements von 1,600 m2.
Exaktes statisches Reifen-Karosserie-Überschneidungsvolumen von null an allen vier Rädern.
Maximale bilaterale Bounding-Box-Abweichung von 0,00347 mm.
Ein reglementsgebundener Geometrie-Screen, der mit null fehlgeschlagenen Prüfungen besteht.
Ein Archiv mit 158 Einträgen mit einem SHA-256-Hash über das Ganze.
Prüfprotokoll für das Geometrie-Referenzmodell.
Jede dieser Zahlen ist ein berechneter Wert, erzeugt von quelloffener Berechnungsgeometrie, nicht eine Behauptung eines Sprachmodells. Das Modell hat den Prozess gesteuert; der Kernel hat die Fakten festgestellt. Das ist dieselbe Arbeitsteilung wie beim Lean-Beweis, angewandt auf ein industrielles Artefakt - und es ist das, was das Ergebnis zu etwas macht, mit dem ein Ingenieur diskutieren kann, statt etwas, dem ein Käufer vertrauen muss.
Und die ehrliche Grenze, so klar ausgesprochen wie intern: Dies ist ein Vorzertifizierungs-Master. Er ist messbar, reimportierbar und unabhängig prüfbar. Er ist nicht FIA- oder ACO-homologiert, nicht freigegeben und nicht fertigungsfähig. Wer Ihnen erzählt, ein Sprachmodell habe ein homologiertes Rennauto hervorgebracht, verkauft Ihnen etwas. Was hervorgebracht wurde, ist ein rigoroser, prüfbarer Ausgangspunkt, der eine enorme Menge der Geometriearbeit beseitigt, die normalerweise der zertifizierbaren Designrunde vorausgeht - und die die nächste Runde dann verdienen muss.
Das ist interne Forschung, kein ausgeliefertes Produkt, obwohl Kunden begonnen haben, eigene Arbeiten darüber laufen zu lassen. Ich sage das lieber, als das Gegenteil zu implizieren.
Wo neuland.ai steht
Der Grund, warum wir das können, ist nicht, dass wir ein besseres Modell haben. Wir haben kein Modell. Es liegt daran, dass die Plattform um die fünf Eigenschaften herum gebaut wurde, die der Mathematik-Fall aufzeigt, weil diese Eigenschaften dieselben sind, die seriöse industrielle Ingenieursarbeit erfordert. [⁶]
Routing über verschiedene Modelle hinweg je nach Workload, ausgewählt nach Leistungsfähigkeit, Kosten, Standort und Richtlinien – und nicht danach, wessen Inferenz wir verkaufen, denn wir verkaufen gar keine. Eine Ontologie, die die kundeneigene Domäne abbildet: Was eine Entität in dessen Werk, dessen Flotte oder dessen Portfolio ist und wie diese Entitäten miteinander in Beziehung stehen. Eine Orchestrierung, die deterministisch ist, wenn ein Ergebnis reproduzierbar sein muss, und agentisch, wenn der Pfad nicht im Voraus aufgezählt werden kann, wobei die Entscheidung pro Aufgabe getroffen wird. Eine Ausführung, die echte Engineering-Tools innerhalb einer Sandbox antreiben kann, anstatt nur zu beschreiben, was solche Tools ausgeben würden. Verifizierung als Schritt erster Ordnung, sodass eine Behauptung durch etwas anderes überprüft wird als durch das Modell, das sie erstellt hat. Und ein ausschließlich nachträglich ergänzbares Protokoll über jeden Abruf, jede Entscheidung und jeden Tool-Aufruf, damit ein Ergebnis auch Monate später noch bis zu seinen Belegen zurückverfolgt werden kann.
Diese Liste ist kein Feature-Vergleich. Sie ist die Antwort auf die Frage, warum ein Sprachmodell helfen kann, ein Millenniumsproblem zu lösen, und es allein nicht schafft, Ihnen zu sagen, ob Ihr R&I-Satz intern konsistent ist.
Persönliche Einschätzung
Ich bin in dieser Serie über zweiundzwanzig Beiträge gemessen worden, also will ich einmal deutlich sein.
Enterprise KI bleibt nicht hinter den Erwartungen zurück, weil die Technologie unreif ist. Im selben Monat, in dem die Ertragszahlen zum zweiten Mal in Folge flach hereinkamen, hat ein Multi-Agenten-System ein Problem geschlossen, an dem Mathematiker seit 1934 gescheitert waren, und Open-Weight-Modelle haben die Frontier zu einem Vierzigstel der Kosten des Vorjahres erreicht. Die Technologie ist außergewöhnlich und sie ist billig.
Enterprise KI bleibt hinter den Erwartungen zurück, weil ein großer Anteil des Geldes in Produkte geflossen ist, die nie hätten funktionieren können, gekauft von Menschen, die keine Möglichkeit hatten, das zu erkennen, von Anbietern, die nicht verpflichtet waren zu erklären, wie irgendetwas funktioniert. Das Ergebnis ist eine branchenweite Verknüpfung der Worte Unternehmens-KI und enttäuschendes Pilotprojekt, die jetzt die Organisationen aktiv zurückhält, die am meisten profitieren würden - die Industrieunternehmen, die Ingenieurbüros, die regulierten Institutionen mit vierzig Jahren angesammeltem Prozesswissen und einem echten Bedarf an Systemen, die darüber nachdenken können.
Diesen Organisationen wurde, durch ihre eigene Erfahrung, gesagt, dass diese Technologie nicht liefert. Was ihnen tatsächlich gesagt wurde, ist, dass eine Chat-Oberfläche über einem Dokumentenspeicher nicht liefert, was schon immer wahr war und was die Forschungsgemeinschaft ihnen umsonst hätte sagen können.
Die Lücke zwischen der Mathematik und der Gewinn-und-Verlust-Rechnung ist keine Lücke in der Fähigkeit. Es ist eine Lücke in der Architektur, und sie wird sich schließen für die Organisationen, die anfangen, Anbieter zu fragen, wie Dinge funktionieren, statt was sie in einer Demo können. Die Werkzeuge, die die Forschungsgemeinschaft über drei Jahrzehnte gebaut hat, liegen da, frei, validiert und darauf wartend, dass jemand sie richtig bedient.
Wir lassen uns lieber an einem Geometriepaket mit einer Hash-Prüfsumme messen als an einer Demo.
Eine kurze Anmerkung zum regulatorischen Hintergrund, da er sich weiterentwickelt. Der EU AI Act wurde am 2. August 2026 in weiten Teilen anwendbar, mit GPAI-Durchsetzungsbefugnissen nach Kapitel V ab diesem Datum; die Digital-Omnibus-Einigung vom 7. Mai 2026 verschob die Hochrisiko-Verpflichtungen nach Annex III auf den 2. Dezember 2027 und die Annex-I-Verpflichtungen auf den 2. August 2028. [⁷] Relevant hier: Eine Architektur, in der Behauptungen durch deterministische Werkzeuge aufgestellt und gegen Evidenz festgehalten werden, ist unter diesem Regime dramatisch leichter zu dokumentieren als eine, in der die Antwort das ist, was das Modell gesagt hat. Der Compliance-Fall und der Engineering-Fall sind derselbe Fall.
Die Theoreme fallen. Die Lücke ist nicht die Technologie. Das ist die Arbeit, die vor uns liegt, und es ist die Arbeit, die wir machen.
Beiträge der Serie unter neuland.ai/en/resources/insights.
Ankündigung von OpenAI vom 8. September 2026 zum Navier-Stokes-Existenz- und Glattheitsproblem, einem der sieben Millennium-Probleme des Clay Mathematics Institute aus dem Jahr 2000. Berichtete Architektur: ein Multi-Agenten-System, koordiniert von einem unveröffentlichten internen Modell, zeitweise mit rund zehntausend parallel laufenden Sub-Agenten, über ungefähr achtundachtzig Stunden, mit einer vereinfachten Fassung der Frage, die zuvor in ungefähr fünfzig Stunden mit rund tausend Agenten beantwortet wurde; Beweis veröffentlicht mit einer Formalisierung in Lean. Prioritätsstreit: Tristan Buckmaster (Courant Institute, NYU) und Levent Alpöge (Harvard) hatten rund ein Jahr an dem Problem gearbeitet, aufbauend auf einem Ansatz von Córdoba und Martínez-Zoroa, am 15. August 2026 Blow-up für die Euler-Gleichungen bewiesen unter Verwendung von Modellen von Anthropic und OpenAI und das Ergebnis in Lean verifiziert, und ihr Ergebnis zum reibungsfreien Fall am 7. September 2026 veröffentlicht mit der Erklärung, eine Lösung des allgemeineren Problems werde folgen. OpenAI hat erklärt, seine Ressourcen am 1. September 2026 auf das Problem gerichtet zu haben, nachdem Gerüchte über diese Arbeit aufgekommen waren. Buckmaster hat öffentlich einen Versuch der Vereinnahmung der Entdeckung vorgeworfen. Buckmasters Darstellung vermerkt auch, dass die natürlichsprachliche Erklärung der Modelle kaum lesbar war und die Schritte für andere Forscher manuell rekonstruiert werden mussten. Berichterstattung: Nature, Fortune, Scientific American, 8.-9. September 2026. Dieser Beitrag bezieht keine Position in der Prioritätsfrage.
McKinsey, State of AI, veröffentlicht 25. August 2026; 1.719 Befragte aus 97 Ländern, erhoben 4. Mai bis 8. Juni 2026, gewichtet nach dem BIP-Anteil jedes Landes. Referenzierte Ergebnisse: 80 Prozent berichten von individuellen Produktivitätsgewinnen gegenüber 37 Prozent mit irgendeiner EBIT-Auswirkung, letztere im Jahresvergleich unverändert; ungefähr 6 Prozent schreiben 5 Prozent oder mehr ihres EBIT der KI zu, ebenfalls unverändert; 32 Prozent lehnten mindestens einen Softwarekauf ab, weil agentische Coding-Werkzeuge internen Bau ermöglichten, mit Branchenvariation von ungefähr 41 Prozent im Technologiesektor bis 19 Prozent in der Versicherungsbranche und 17 Prozent im öffentlichen Sektor; große Unternehmen, die Agenten in einer oder mehreren Funktionen skalieren, stiegen von 27 auf 40 Prozent, während kleinere Organisationen bei 22 Prozent verharrten; 20 Prozent berichten, dass KI-Betriebskosten einschließlich Token-Kosten ihren KI-Einsatz eingeschränkt haben.
Gartner-CIO-Umfragedaten, wonach ungefähr 17 Prozent der Organisationen KI-Agenten eingesetzt haben; Deloitte Tech Trends 2026 setzt produktionsreife agentische Systeme bei ungefähr 11 Prozent an.
Siehe frühere Beiträge dieser Serie mit dem Argument, dass die sinnvolle Einheit das definierte Ergebnis ist und nicht der manuell konstruierte Ablauf, und dass eine Plattform die kontrollierte Grundlage bereitstellen sollte, auf der ein Agent läuft, statt zu versuchen, der Agent zu sein.
Zu den referenzierten Architektureigenschaften und dem Argument, dass sie zum Zeitpunkt des Entwurfs entschieden werden und nicht nachträglich hinzugefügt werden können, siehe den früheren Beitrag dieser Serie mit der Definition einer KI-Orchestrierungs- und -Management-Plattform für Unternehmen.
Rat der EU und Europäisches Parlament, vorläufige politische Einigung zum Digital Omnibus zur KI, 7. Mai 2026: Hochrisiko-Verpflichtungen nach Annex III verschoben auf 2. Dezember 2027; Annex-I-Verpflichtungen verschoben auf 2. August 2028; Wasserzeichenverpflichtungen nach Artikel 50(2) verschoben auf 2. Dezember 2026. GPAI-Durchsetzungsbefugnisse nach Kapitel V verbindlich ab 2. August 2026.