AI Strategy
Auf der Schachtel stand Rind. Die Antworten sagten Kimi.
Auf der Schachtel stand Rind. Die Antworten sagten Kimi.
Dr. Anoj Winston Gladius
·
14
Min. Lesezeit
aufsatz
Bild: KI generiert mit neuland.ai HUB
Über Modell-Herkunft, einen europäischen Lebensmittelskandal und die Frage, die jedes Unternehmen seinen KI-Anbietern stellen sollte.

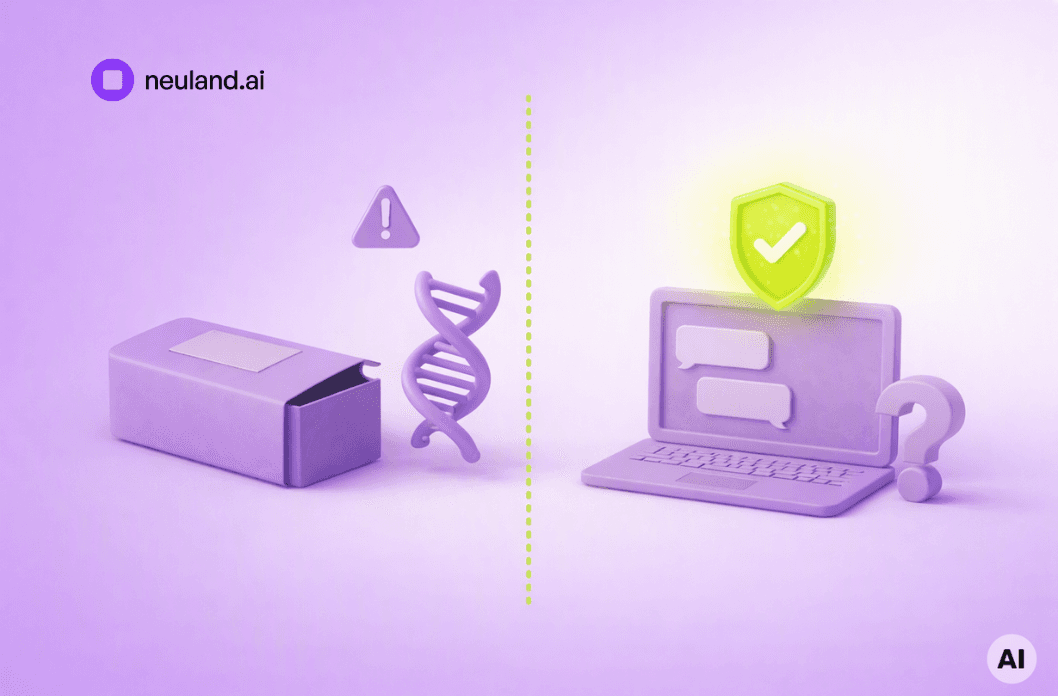
Ein Etikett und dessen Inhalt. 2013: Bei DNA-Tests wurde in als Rindfleisch gekennzeichneten Produkten Pferdefleisch nachgewiesen (Anmerkung 7). 2026: wie im Bedrohungsbericht von Anthropic behauptet (Anmerkung 2). Originalillustration von neuland.ai.
Am 10. September 2026 veröffentlichte Anthropic einen 154-seitigen Bedrohungsbericht, in dem sieben chinesische KI-Labore beschuldigt werden, die Anfragen ihrer Kunden durch Anthropics Claude-Modelle geleitet zu haben, um die Antworten abzuschöpfen. Der auffälligste Fall war Moonshot. Laut dem Bericht wurden Anfragen von Nutzern des Kimi-Assistenten stillschweigend an Claude weitergeleitet – und Claudes Antwort wurde dem Nutzer so präsentiert, als hätte Kimi sie verfasst. Mehr als 23 Millionen Anfragen zwischen Mai und Juli, abgewickelt über Tausende betrügerischer Konten. DeepSeek soll in nur zwei Wochen 12,1 Millionen Anfragen weitergeleitet haben. Einige der weitergeleiteten Anfragen enthielten Berichten zufolge polizei- und militärbezogene Daten. Zwölf Tage später bestellte Chinas eigene Internetbehörde alle sieben Unternehmen ein. Die Nutzer wussten es nie. Und offenbar auch nicht der Staat mit den strengsten Datenlokalisierungsregeln der Welt.
Europa hat das schon einmal erlebt. Im Januar 2013 fanden irische Lebensmittelkontrolleure Pferde-DNA in Burgern, die als Rindfleisch verkauft wurden – und innerhalb weniger Wochen stellte sich heraus, dass tiefgekühlte Lasagne einer bekannten Marke fast ausschließlich aus Pferdefleisch bestand. Die Packung sagte Rind. 2026 sagten die Antworten Kimi.
Das wirft eine Frage auf, die die wenigsten europäischen Unternehmen mit Sicherheit beantworten können: Welches Modell beantwortet eigentlich die Anfragen Ihres Unternehmens?
Dieser Beitrag handelt von einem Problem, das Europa in seiner Lebensmittelversorgung bereits einmal gelöst hat: zu wissen, was wirklich in einem Produkt steckt, das das Etikett eines anderen trägt – und warum künstliche Intelligenz derzeit keine Möglichkeit hat, Ihnen das zu sagen.¹
Ein Etikett ist eine Behauptung. Herkunft ist ein Nachweis. Enterprise-KI läuft noch fast ausschließlich auf Behauptungen.
Was der Bericht sagt
Anthropics Bericht, veröffentlicht am 10. September unter dem Titel „Detecting and countering misuse of AI", deckt Aktivitäten ab, die zwischen Dezember 2025 und August 2026 festgestellt wurden. Er nennt sieben in China ansässige Labore: Alibaba, Moonshot, DeepSeek, Zhipu, MiniMax, Xiaomi und SenseTime. Der zentrale Vorwurf ist das, was das Unternehmen „illegale Destillation" nennt – das massenhafte Einsenden von Anfragen an Claude, um dessen Antworten zum Training konkurrierender Modelle zu nutzen. Über alle sieben Labore hinweg beziffert die Berichterstattung die Gesamtzahl auf rund 190 Millionen Anfragen.²
Zwei Fälle gingen über die Destillation hinaus. Im Fall Moonshot wurden laut Bericht Anfragen, die Kimis eigene Kunden gestellt hatten, an Claude weitergeleitet und Claudes Antworten diesen Kunden als Kimis eigene präsentiert – in einem Zehntageszeitraum rund 300.000 Anfragen über 5.380 betrügerische Konten, die größtenteils in Singapur und Japan verortet schienen, die große Mehrheit an Claudes Opus-Modelle gesendet. Anthropic gab an, nicht zu wissen, ob Moonshot seine Kunden informiert hatte. DeepSeek soll im Juli innerhalb von vierzehn Tagen mehr als 12,1 Millionen Anfragen generiert haben. Und einige der weitergeleiteten Anfragen enthielten Berichten zufolge Material mit Bezug zu chinesischer Polizei und Militär – darunter in einem Fall die Anfrage eines Nutzers samt angehängtem Videomaterial.³
Dies sind Vorwürfe eines Unternehmens mit einem offensichtlichen kommerziellen Interesse am Ausgang, und die Labore hatten zum Zeitpunkt der Berichterstattung nicht reagiert.² Die strukturelle Lehre hängt nicht davon ab, ob jedes Detail stimmt.

Abbildung 1. Der „Moonshot“-Fall, wie er im Bedrohungsbericht von Anthropic beschrieben wird. Originaldiagramm von neuland.ai; Quellenangaben in Anmerkung 2.
Das Land, das es nicht sehen konnte
China hat einige der strengsten Regeln der Welt für die grenzüberschreitende Übermittlung personenbezogener Daten. Seine Datensicherheits- und Datenschutzgesetze verlangen Sicherheitsbewertungen, Genehmigungen oder Standardverträge, bevor personenbezogene Daten das Land verlassen.⁴ Die Regulierungsbehörde ist nicht ohne Befugnisse.
Und dennoch wurde das Routing nicht in Peking entdeckt. Es wurde in San Francisco entdeckt – in den Protokollen des Unternehmens, das den Datenverkehr empfing. Die Abfolge lohnt es, genau zu lesen: Am 9. September veröffentlichten NSA, FBI und CISA eine Warnung, in der sechs chinesische KI-Unternehmen namentlich genannt wurden. Am 10. September wies China diese Warnung als haltlos zurück – am selben Tag, an dem Anthropics Bericht erschien. Am 22. September bestellte die Cyberspace Administration of China Vertreter aller sieben im Bericht genannten Unternehmen ein, bevor sie ihre Untersuchung auf DeepSeek und Moonshot verengte.⁵ Washington hat DeepSeek inzwischen für zivile Bundesbehörden gesperrt und behandelt es als Lieferkettenrisiko.⁶
Die mächtigste Datenschutzbehörde der Welt erfuhr, wohin die Anfragen ihrer eigenen Bürger gegangen waren, aus dem Bedrohungsbericht eines ausländischen Unternehmens. Das ist der entscheidende Punkt. Wer die Protokolle hat, kennt die Wahrheit. Alle anderen halten ein Etikett in der Hand.

Abbildung 2. Das angebliche Ausmaß und wie die Geschichte die Aufsichtsbehörden erreichte. Originalgrafik von neuland.ai; Quellen in den Anmerkungen 2, 5 und 6.
2013: Die Packung sagte Rind
Im Dezember 2012 testete die irische Lebensmittelbehörde im Rahmen ihrer Routineüberwachung eine Reihe von Tiefkühlprodukten und fand DNA, die sie nicht identifizieren konnte. Sie testete die Proben erneut – diesmal auf Rind, Schwein und Pferd. Am 15. Januar 2013 gab sie die Ergebnisse bekannt: Mehr als ein Drittel der getesteten Rindfleischprodukte enthielt Pferde-DNA, und in den Billigburgern eines Supermarkts machte Pferdefleisch rund 29 Prozent des Fleischanteils aus. Innerhalb weniger Wochen stellte sich heraus, dass tiefgekühlte Rindfleisch-Lasagne der Marke Findus, hergestellt vom französischen Hersteller Comigel, zwischen 80 und 100 Prozent Pferdefleisch enthielt.⁷
Das Fleisch hatte eine Reise hinter sich. Laut den französischen Behörden waren rumänische Schlachthöfe sowie niederländische und zypriotische Händler Teil der Kette, die mit Pferdefleisch endete, das als Rind etikettiert war – über einen Fleischverarbeiter und einen Tiefkühlkosthersteller, bevor es die Marken auf der Packung erreichte.⁷ Die meisten Einzelhändler, die diese Produkte verkauften, hatten keine Ahnung. Und ein Detail ist hier wichtiger als alle anderen: Bis dahin hatten Supermärkte und Kontrolleure Rindfleisch nicht auf Pferd getestet – weil niemand damit gerechnet hatte.⁷
Europas Reaktion bestand nicht darin, die Verbraucher zu bitten, den Marken mehr zu vertrauen. Die Kommission startete ein EU-weites DNA-Testprogramm, und die Branche lernte, den Inhalt ihrer eigenen Lieferketten zu testen, anstatt sich auf das Etikett des nächsten Lieferanten zu verlassen.⁷ Rückverfolgbarkeit hörte auf, etwas zu sein, das man voraussetzte – und wurde zu etwas, das man beweisen konnte.
Jede Antwort ist ungezeichnet
Eine Antwort eines KI-Systems ist die Tiefkühl-Lasagne des Jahres 2026: eine Markenverpackung über einer Lieferkette, die niemand weiter unten sehen kann. Sie trägt kein Herkunftsmerkmal. Ein Absatz von Kimi und ein Absatz von Claude sehen auf dem Bildschirm gleich aus. Genauso wie ein Absatz eines europäischen „souveränen" Assistenten, der im Hintergrund ein amerikanisches Modell aufruft – was frühere Beiträge dieser Reihe als europäisches Schaufenster bezeichnet haben. Der Nutzer sieht eine Marke.⁸ Das Modell dahinter ist unsichtbar, es sei denn, jemand entscheidet sich, es offenzulegen.
Herkunft ist nicht unentdeckbar. KI hat ihre eigenen DNA-Tests: Im August identifizierten Entwickler ein anonymes Modell auf einer öffentlichen Plattform, indem sie seinen Tokenizer analysierten und ihn der GLM-Familie zuordneten, bevor Z.ai es bestätigte.⁹ Anthropic identifizierte das Kimi-Routing anhand von Mustern in Konten, Proxys und Datenverkehr. Aber beide Entdeckungen wurden von Menschen gemacht, die den Datenverkehr sehen konnten. Der Unternehmenskunde eines Wrappers kann das nicht – und testet, wie die Supermärkte 2012, meistens gar nicht, weil niemand mit einer Substitution rechnet.
Für ein Unternehmen sind die Konsequenzen konkret:
Datenpfad: Ihre Anfrage und alle mitgesendeten Dokumente gingen an einen Ort, den Sie nicht gewählt haben.
Evaluierung: Sie haben ein Modell getestet und werden mit einem anderen bedient.
Kontinuität: Als Anthropic die Konten sperrte, änderte sich der Dienst hinter dem Kimi-Label über Nacht – und die Nutzer hatten keine Möglichkeit zu wissen, warum.
Training: Ob Ihre Anfragen zum Training von Modellen genutzt werden, hängt vom Tarif und Anbieter ab – und Sie können einen Anbieter nicht prüfen, von dem Sie nicht wissen, dass er beteiligt ist.¹⁰
Rechenschaftspflicht: Wenn ein Prüfer fragt, welches Modell vor sechs Monaten eine Entscheidung getroffen hat, ist „das auf dem Etikett" keine Antwort.
Routing ist nicht das Problem – verstecktes Routing ist es
Es wäre leicht, die falsche Lehre daraus zu ziehen. Eine schwierige Frage an ein stärkeres Modell weiterzuleiten ist gutes Engineering. Wir tun es selbst, und jede ernsthafte KI-Plattform auch. Die Person, die das Kimi-Routing eingerichtet hat, hat möglicherweise eine pragmatische Entscheidung getroffen, um Kunden zufriedenzustellen, während das eigene Modell aufholte.
Der Unterschied liegt nicht darin, ob Routing stattfindet. Er liegt in drei Fragen: Wer entscheidet? Wer weiß es? Und wer kann es hinterher beweisen? Im Fall Moonshot hat laut Bericht der Anbieter entschieden, der Kunde wusste es nicht, und niemand außerhalb konnte irgendetwas beweisen, bis ein Dritter seine Protokolle veröffentlichte. In einem geregelten System entscheidet die Richtlinie des Kunden, das Routing ist sichtbar, jede Anfrage wird mit dem Modell aufgezeichnet, das sie bearbeitet hat, und bestimmte Daten verlassen niemals Modelle, die auf der eigenen Infrastruktur des Kunden laufen.

Abbildung 3. Verstecktes Routing und geregeltes Routing. Originaldiagramm von neuland.ai.
Der Modell-Herkunfts-Check
Kreuzen Sie jede Aussage an, die heute für Ihr Unternehmen zutrifft:
Aussage | Schicht | |
|---|---|---|
☐ | 1. Unsere KI-Anbieter teilen uns schriftlich mit, welches Modell unsere Anfragen standardmäßig beantwortet. | Offenlegung |
☐ | 2. Wir werden informiert, bevor ein Anbieter ein anderes Modell wechselt, hinzufügt oder als Fallback nutzt. | Offenlegung |
☐ | 3. Wir wissen, ob unsere Anfragen für das Training genutzt werden – bei jedem Tarif, den unsere Mitarbeiter verwenden. | Offenlegung |
☐ | 4. Jede Anfrage wird mit dem Modell, der Version und dem Standort aufgezeichnet, der sie verarbeitet hat. | Nachweis |
☐ | 5. Dieser Nachweis wird von einer Plattform geschrieben, die wir kontrollieren – nicht nur vom Anbieter. | Nachweis |
☐ | 6. Wir könnten einem Prüfer zeigen, welches Modell vor sechs Monaten eine bestimmte Antwort erzeugt hat. | Nachweis |
☐ | 7. Sensible Datenkategorien sind an Modelle gebunden, die auf unserer eigenen Infrastruktur laufen. | Kontrolle |
☐ | 8. Keine Anfrage verlässt unsere Infrastruktur, es sei denn, unsere Richtlinie erlaubt es. | Kontrolle |
☐ | 9. Wir haben das Modell evaluiert, das uns tatsächlich geliefert wird – nicht nur das aus der Verkaufspräsentation. | Kontrolle |
☐ | 10. Wir haben getestet, was unsere KI tut, wenn ein vorgelagertes Modell gesperrt wird. | Kontrolle |
Ihr Ergebnis:
8–10 Kreuze | Ihre Antworten tragen ihre Herkunft. Sie könnten beweisen, welches Modell jede von ihnen erzeugt hat. |
4–7 Kreuze | Einige Ihrer Antworten stammen von Modellen, die Sie nicht gewählt haben. Beginnen Sie mit dem Nachweis – das ist das Einzige, was ein Anbieter Ihnen im Nachhinein nicht geben kann. |
0–3 Kreuze | Sie vertrauen einem Etikett. |
Was das für europäische Unternehmen bedeutet
In Europa ist verstecktes Routing nicht nur eine Frage guter Praxis. Unter der DSGVO darf ein Auftragsverarbeiter keinen weiteren Auftragsverarbeiter einschalten, ohne die vorherige schriftliche Genehmigung des Verantwortlichen – und die Übermittlung personenbezogener Daten außerhalb des Europäischen Wirtschaftsraums unterliegt eigenen Regeln.¹¹ Ein KI-Anbieter, der Anfragen mit personenbezogenen Daten stillschweigend an einen anderen Modellanbieter weiterleitet, fügt faktisch einen Unterauftragsverarbeiter hinzu, den sein Kunde nie genehmigt hat. Die Pferdefleisch-Kette ist ein treffendes Bild dafür, wie das im großen Maßstab aussieht: Jedes Glied gibt das Produkt weiter, keines ist dem Kunden am Ende gegenüber rechenschaftspflichtig. Die meisten europäischen Datenschutzbeauftragten möchten von einer solchen Kette erfahren, bevor sie existiert – nicht aus einem Bedrohungsbericht.
Die praktische Antwort ist die von 2013, angewendet auf Antworten statt auf Lasagne: Vertrauen Sie nicht dem Etikett. Testen Sie, was drin ist. Verlangen Sie, dass die Herkunft angegeben wird – welches Modell, welche Version, wo es lief – und zwar anfragenweise aufgezeichnet, von einer Plattform, die Sie kontrollieren, nicht nur vom Anbieter. Für Daten, die das Gebäude nicht verlassen dürfen, binden Sie sie an Modelle, die auf Ihrer eigenen Hardware laufen. Open-Weight-Modelle auf Ihren eigenen Servern können eine Anfrage nirgendwohin weiterleiten. Das ist ihr Sinn.
Wo neuland.ai steht
Der neuland.ai HUB verteilt Aufgaben zwischen Modellen – und genau deshalb zeichnet er das Routing auf. Jede Aufgabe wird gemäß der eigenen Richtlinie des Kunden verteilt: über intern gehostete Open-Weight-Modelle wie Mistral, Nemotron, GLM, Qwen und DeepSeek sowie proprietäre Modelle wie Claude und GPT, wo der Kunde sie erlaubt. Jede Anfrage wird mit dem Modell aufgezeichnet, das sie bearbeitet hat – zusammen mit den Abrufen, Tool-Aufrufen und Entscheidungen drumherum – in einem Nachweis, der dem Kunden gehört. Datenkategorien können an Modelle gebunden werden, die auf der eigenen Infrastruktur des Kunden laufen, und der Aufruf eines externen Modells ist eine Richtlinienentscheidung des Kunden – kein Standard, den die Plattform für ihn trifft.¹²
Das ist auch die Antwort auf eine Frage, die wir von Datenschutzbeauftragten immer häufiger hören: Können Sie uns sagen, welches Modell eine bestimmte Antwort erzeugt hat? Ja – anfragenweise, und sechs Monate später.
Persönliches Fazit
Ein Wort zur Fairness. Die Fakten im Zentrum dieses Beitrags sind Vorwürfe eines Unternehmens gegen mehrere seiner Wettbewerber, zu einem Zeitpunkt, an dem dieses Unternehmen jeden Grund hat, seinen Fall lautstark zu vertreten. Die genannten Labore hatten nicht reagiert, als der Bericht erschien, und China hat die einen Tag zuvor veröffentlichte amerikanische Warnung zurückgewiesen. Nichts davon ist geklärt, und dieser Beitrag versucht nicht, es zu klären.
Wogegen ich mich ausspreche, ist etwas, das nicht davon abhängt, wer recht hat: die Gewohnheit, die Marke eines KI-Produkts als Beweis für seinen Inhalt zu behandeln. 2013 lernte Europa auf die teure Art, dass ein Etikett auf einer Packung eine Behauptung ist, kein Nachweis – und dass die einzige verlässliche Antwort darin besteht, den Inhalt zu testen und seine Herkunft zurückzuverfolgen. Enterprise-KI hat diese Lektion noch nicht gelernt. Bis Regulatoren dort ankommen, kann jedes Unternehmen es für sich selbst tun.
Wir bei neuland.ai stempeln lieber jede Antwort mit dem Modell, das sie erzeugt hat, als unsere Kunden zu bitten, dem Etikett zu vertrauen.
[1] Alle Artikel der Reihe verfügbar unter: neuland.ai
[2] Anthropic, „Detecting and countering misuse of AI", Bedrohungsbericht, 10. September 2026, Zeitraum Dezember 2025 bis August 2026; berichtet von CNBC (11. September 2026), South China Morning Post (11. September 2026) und Better Stack (14. September 2026). Gesamtzahl von rund 190 Millionen Anfragen über alle sieben Labore laut Berichterstattung.
[3] Startup Fortune und Quartz, September 2026, zu weitergeleiteten Anfragen, die Berichten zufolge polizei- und militärbezogenes Material enthielten, darunter eine Nutzeranfrage mit angehängtem Videomaterial.
[4] Volksrepublik China, Gesetz zum Schutz personenbezogener Informationen (2021) und Datensicherheitsgesetz (2021), einschließlich der Regeln für grenzüberschreitende Übermittlungen personenbezogener Informationen.
[5] The Information, berichtet von The Next Web, Quartz und AI Weekly, 22.–23. September 2026, zur Einbestellung aller sieben Unternehmen durch die Cyberspace Administration of China und zur Verengung der Untersuchung auf DeepSeek und Moonshot; The Next Web zur NSA-, FBI- und CISA-Warnung vom 9. September 2026 und Chinas Zurückweisung am 10. September 2026.
[6] Startup Fortune, Oktober 2026, zum Verbot von DeepSeek für zivile Bundesbehörden und Regierungsaufträge durch das US-Heimatschutzministerium als Lieferkettenrisiko.
[7] Zum Pferdefleischskandal 2013: Europäische Kommission, „Pferdefleisch – Fragen und Antworten", zu den Befunden irischer Kontrolleure im Januar 2013, Findus-Rindfleischlasagne von Comigel mit 80 bis 100 Prozent Pferdefleisch und dem EU-weiten Testprogramm; en.wikipedia.org zu den am 15. Januar 2013 bekannt gegebenen FSAI-Ergebnissen; NBC News, Februar 2013, zum Bericht der französischen Behörden über rumänische Schlachthöfe sowie niederländische und zypriotische Händler in der Lieferkette; REHIS, „Horse meat scandal — a decade on" (2023), zum Fehlen von Pferdetests in Rindfleisch vor 2013 und zum EU-weiten DNA-Testprogramm.
[8] Siehe den früheren Beitrag dieser Reihe zum KI-Kapitalgeflecht und zu europäischen Schaufenstern für amerikanische Modelle.
[9] Siehe den früheren Beitrag dieser Reihe zur Blind-Evaluierung und zum anonymen Modell Ox Alpha.
[10] Siehe den früheren Beitrag dieser Reihe zum KI-Kapitalgeflecht, einschließlich der Standard-Trainingseinstellungen von Consumer- und Enterprise-KI-Tarifen.
[11] Verordnung (EU) 2016/679 (DSGVO), Artikel 28 Absatz 2, zur Einschaltung eines weiteren Auftragsverarbeiters nur mit vorheriger spezifischer oder allgemeiner schriftlicher Genehmigung des Verantwortlichen, sowie Kapitel V zur Übermittlung personenbezogener Daten in Drittländer.
[12] neuland.ai HUB: aufgabenbasiertes Modell-Routing gemäß kundenseitig festgelegter Richtlinien über selbst gehostete Open-Weight- und proprietäre Modelle; anfragenweiser Nachweis des verwendeten Modells samt Abrufen, Tool-Aufrufen und Entscheidungen in einem unveränderlichen, kundeneigenen Audit-Protokoll; Bindung von Datenkategorien an Modelle auf Kundeninfrastruktur; Bereitstellung on-premises, in einer europäischen Sovereign Cloud oder air-gapped. Die neuland.ai AG trägt die Verantwortung für die inhaltliche Qualität und die saubere Lieferung von Ergebnissen in allen Kundenprojekten.
Über Modell-Herkunft, einen europäischen Lebensmittelskandal und die Frage, die jedes Unternehmen seinen KI-Anbietern stellen sollte.
Ein Etikett und dessen Inhalt. 2013: Bei DNA-Tests wurde in als Rindfleisch gekennzeichneten Produkten Pferdefleisch nachgewiesen (Anmerkung 7). 2026: wie im Bedrohungsbericht von Anthropic behauptet (Anmerkung 2). Originalillustration von neuland.ai.
Am 10. September 2026 veröffentlichte Anthropic einen 154-seitigen Bedrohungsbericht, in dem sieben chinesische KI-Labore beschuldigt werden, die Anfragen ihrer Kunden durch Anthropics Claude-Modelle geleitet zu haben, um die Antworten abzuschöpfen. Der auffälligste Fall war Moonshot. Laut dem Bericht wurden Anfragen von Nutzern des Kimi-Assistenten stillschweigend an Claude weitergeleitet – und Claudes Antwort wurde dem Nutzer so präsentiert, als hätte Kimi sie verfasst. Mehr als 23 Millionen Anfragen zwischen Mai und Juli, abgewickelt über Tausende betrügerischer Konten. DeepSeek soll in nur zwei Wochen 12,1 Millionen Anfragen weitergeleitet haben. Einige der weitergeleiteten Anfragen enthielten Berichten zufolge polizei- und militärbezogene Daten. Zwölf Tage später bestellte Chinas eigene Internetbehörde alle sieben Unternehmen ein. Die Nutzer wussten es nie. Und offenbar auch nicht der Staat mit den strengsten Datenlokalisierungsregeln der Welt.
Europa hat das schon einmal erlebt. Im Januar 2013 fanden irische Lebensmittelkontrolleure Pferde-DNA in Burgern, die als Rindfleisch verkauft wurden – und innerhalb weniger Wochen stellte sich heraus, dass tiefgekühlte Lasagne einer bekannten Marke fast ausschließlich aus Pferdefleisch bestand. Die Packung sagte Rind. 2026 sagten die Antworten Kimi.
Das wirft eine Frage auf, die die wenigsten europäischen Unternehmen mit Sicherheit beantworten können: Welches Modell beantwortet eigentlich die Anfragen Ihres Unternehmens?
Dieser Beitrag handelt von einem Problem, das Europa in seiner Lebensmittelversorgung bereits einmal gelöst hat: zu wissen, was wirklich in einem Produkt steckt, das das Etikett eines anderen trägt – und warum künstliche Intelligenz derzeit keine Möglichkeit hat, Ihnen das zu sagen.¹
Ein Etikett ist eine Behauptung. Herkunft ist ein Nachweis. Enterprise-KI läuft noch fast ausschließlich auf Behauptungen.
Was der Bericht sagt
Anthropics Bericht, veröffentlicht am 10. September unter dem Titel „Detecting and countering misuse of AI", deckt Aktivitäten ab, die zwischen Dezember 2025 und August 2026 festgestellt wurden. Er nennt sieben in China ansässige Labore: Alibaba, Moonshot, DeepSeek, Zhipu, MiniMax, Xiaomi und SenseTime. Der zentrale Vorwurf ist das, was das Unternehmen „illegale Destillation" nennt – das massenhafte Einsenden von Anfragen an Claude, um dessen Antworten zum Training konkurrierender Modelle zu nutzen. Über alle sieben Labore hinweg beziffert die Berichterstattung die Gesamtzahl auf rund 190 Millionen Anfragen.²
Zwei Fälle gingen über die Destillation hinaus. Im Fall Moonshot wurden laut Bericht Anfragen, die Kimis eigene Kunden gestellt hatten, an Claude weitergeleitet und Claudes Antworten diesen Kunden als Kimis eigene präsentiert – in einem Zehntageszeitraum rund 300.000 Anfragen über 5.380 betrügerische Konten, die größtenteils in Singapur und Japan verortet schienen, die große Mehrheit an Claudes Opus-Modelle gesendet. Anthropic gab an, nicht zu wissen, ob Moonshot seine Kunden informiert hatte. DeepSeek soll im Juli innerhalb von vierzehn Tagen mehr als 12,1 Millionen Anfragen generiert haben. Und einige der weitergeleiteten Anfragen enthielten Berichten zufolge Material mit Bezug zu chinesischer Polizei und Militär – darunter in einem Fall die Anfrage eines Nutzers samt angehängtem Videomaterial.³
Dies sind Vorwürfe eines Unternehmens mit einem offensichtlichen kommerziellen Interesse am Ausgang, und die Labore hatten zum Zeitpunkt der Berichterstattung nicht reagiert.² Die strukturelle Lehre hängt nicht davon ab, ob jedes Detail stimmt.
Abbildung 1. Der „Moonshot“-Fall, wie er im Bedrohungsbericht von Anthropic beschrieben wird. Originaldiagramm von neuland.ai; Quellenangaben in Anmerkung 2.
Das Land, das es nicht sehen konnte
China hat einige der strengsten Regeln der Welt für die grenzüberschreitende Übermittlung personenbezogener Daten. Seine Datensicherheits- und Datenschutzgesetze verlangen Sicherheitsbewertungen, Genehmigungen oder Standardverträge, bevor personenbezogene Daten das Land verlassen.⁴ Die Regulierungsbehörde ist nicht ohne Befugnisse.
Und dennoch wurde das Routing nicht in Peking entdeckt. Es wurde in San Francisco entdeckt – in den Protokollen des Unternehmens, das den Datenverkehr empfing. Die Abfolge lohnt es, genau zu lesen: Am 9. September veröffentlichten NSA, FBI und CISA eine Warnung, in der sechs chinesische KI-Unternehmen namentlich genannt wurden. Am 10. September wies China diese Warnung als haltlos zurück – am selben Tag, an dem Anthropics Bericht erschien. Am 22. September bestellte die Cyberspace Administration of China Vertreter aller sieben im Bericht genannten Unternehmen ein, bevor sie ihre Untersuchung auf DeepSeek und Moonshot verengte.⁵ Washington hat DeepSeek inzwischen für zivile Bundesbehörden gesperrt und behandelt es als Lieferkettenrisiko.⁶
Die mächtigste Datenschutzbehörde der Welt erfuhr, wohin die Anfragen ihrer eigenen Bürger gegangen waren, aus dem Bedrohungsbericht eines ausländischen Unternehmens. Das ist der entscheidende Punkt. Wer die Protokolle hat, kennt die Wahrheit. Alle anderen halten ein Etikett in der Hand.
Abbildung 2. Das angebliche Ausmaß und wie die Geschichte die Aufsichtsbehörden erreichte. Originalgrafik von neuland.ai; Quellen in den Anmerkungen 2, 5 und 6.
2013: Die Packung sagte Rind
Im Dezember 2012 testete die irische Lebensmittelbehörde im Rahmen ihrer Routineüberwachung eine Reihe von Tiefkühlprodukten und fand DNA, die sie nicht identifizieren konnte. Sie testete die Proben erneut – diesmal auf Rind, Schwein und Pferd. Am 15. Januar 2013 gab sie die Ergebnisse bekannt: Mehr als ein Drittel der getesteten Rindfleischprodukte enthielt Pferde-DNA, und in den Billigburgern eines Supermarkts machte Pferdefleisch rund 29 Prozent des Fleischanteils aus. Innerhalb weniger Wochen stellte sich heraus, dass tiefgekühlte Rindfleisch-Lasagne der Marke Findus, hergestellt vom französischen Hersteller Comigel, zwischen 80 und 100 Prozent Pferdefleisch enthielt.⁷
Das Fleisch hatte eine Reise hinter sich. Laut den französischen Behörden waren rumänische Schlachthöfe sowie niederländische und zypriotische Händler Teil der Kette, die mit Pferdefleisch endete, das als Rind etikettiert war – über einen Fleischverarbeiter und einen Tiefkühlkosthersteller, bevor es die Marken auf der Packung erreichte.⁷ Die meisten Einzelhändler, die diese Produkte verkauften, hatten keine Ahnung. Und ein Detail ist hier wichtiger als alle anderen: Bis dahin hatten Supermärkte und Kontrolleure Rindfleisch nicht auf Pferd getestet – weil niemand damit gerechnet hatte.⁷
Europas Reaktion bestand nicht darin, die Verbraucher zu bitten, den Marken mehr zu vertrauen. Die Kommission startete ein EU-weites DNA-Testprogramm, und die Branche lernte, den Inhalt ihrer eigenen Lieferketten zu testen, anstatt sich auf das Etikett des nächsten Lieferanten zu verlassen.⁷ Rückverfolgbarkeit hörte auf, etwas zu sein, das man voraussetzte – und wurde zu etwas, das man beweisen konnte.
Jede Antwort ist ungezeichnet
Eine Antwort eines KI-Systems ist die Tiefkühl-Lasagne des Jahres 2026: eine Markenverpackung über einer Lieferkette, die niemand weiter unten sehen kann. Sie trägt kein Herkunftsmerkmal. Ein Absatz von Kimi und ein Absatz von Claude sehen auf dem Bildschirm gleich aus. Genauso wie ein Absatz eines europäischen „souveränen" Assistenten, der im Hintergrund ein amerikanisches Modell aufruft – was frühere Beiträge dieser Reihe als europäisches Schaufenster bezeichnet haben. Der Nutzer sieht eine Marke.⁸ Das Modell dahinter ist unsichtbar, es sei denn, jemand entscheidet sich, es offenzulegen.
Herkunft ist nicht unentdeckbar. KI hat ihre eigenen DNA-Tests: Im August identifizierten Entwickler ein anonymes Modell auf einer öffentlichen Plattform, indem sie seinen Tokenizer analysierten und ihn der GLM-Familie zuordneten, bevor Z.ai es bestätigte.⁹ Anthropic identifizierte das Kimi-Routing anhand von Mustern in Konten, Proxys und Datenverkehr. Aber beide Entdeckungen wurden von Menschen gemacht, die den Datenverkehr sehen konnten. Der Unternehmenskunde eines Wrappers kann das nicht – und testet, wie die Supermärkte 2012, meistens gar nicht, weil niemand mit einer Substitution rechnet.
Für ein Unternehmen sind die Konsequenzen konkret:
Datenpfad: Ihre Anfrage und alle mitgesendeten Dokumente gingen an einen Ort, den Sie nicht gewählt haben.
Evaluierung: Sie haben ein Modell getestet und werden mit einem anderen bedient.
Kontinuität: Als Anthropic die Konten sperrte, änderte sich der Dienst hinter dem Kimi-Label über Nacht – und die Nutzer hatten keine Möglichkeit zu wissen, warum.
Training: Ob Ihre Anfragen zum Training von Modellen genutzt werden, hängt vom Tarif und Anbieter ab – und Sie können einen Anbieter nicht prüfen, von dem Sie nicht wissen, dass er beteiligt ist.¹⁰
Rechenschaftspflicht: Wenn ein Prüfer fragt, welches Modell vor sechs Monaten eine Entscheidung getroffen hat, ist „das auf dem Etikett" keine Antwort.
Routing ist nicht das Problem – verstecktes Routing ist es
Es wäre leicht, die falsche Lehre daraus zu ziehen. Eine schwierige Frage an ein stärkeres Modell weiterzuleiten ist gutes Engineering. Wir tun es selbst, und jede ernsthafte KI-Plattform auch. Die Person, die das Kimi-Routing eingerichtet hat, hat möglicherweise eine pragmatische Entscheidung getroffen, um Kunden zufriedenzustellen, während das eigene Modell aufholte.
Der Unterschied liegt nicht darin, ob Routing stattfindet. Er liegt in drei Fragen: Wer entscheidet? Wer weiß es? Und wer kann es hinterher beweisen? Im Fall Moonshot hat laut Bericht der Anbieter entschieden, der Kunde wusste es nicht, und niemand außerhalb konnte irgendetwas beweisen, bis ein Dritter seine Protokolle veröffentlichte. In einem geregelten System entscheidet die Richtlinie des Kunden, das Routing ist sichtbar, jede Anfrage wird mit dem Modell aufgezeichnet, das sie bearbeitet hat, und bestimmte Daten verlassen niemals Modelle, die auf der eigenen Infrastruktur des Kunden laufen.
Abbildung 3. Verstecktes Routing und geregeltes Routing. Originaldiagramm von neuland.ai.
Der Modell-Herkunfts-Check
Kreuzen Sie jede Aussage an, die heute für Ihr Unternehmen zutrifft:
Aussage | Schicht | |
|---|---|---|
☐ | 1. Unsere KI-Anbieter teilen uns schriftlich mit, welches Modell unsere Anfragen standardmäßig beantwortet. | Offenlegung |
☐ | 2. Wir werden informiert, bevor ein Anbieter ein anderes Modell wechselt, hinzufügt oder als Fallback nutzt. | Offenlegung |
☐ | 3. Wir wissen, ob unsere Anfragen für das Training genutzt werden – bei jedem Tarif, den unsere Mitarbeiter verwenden. | Offenlegung |
☐ | 4. Jede Anfrage wird mit dem Modell, der Version und dem Standort aufgezeichnet, der sie verarbeitet hat. | Nachweis |
☐ | 5. Dieser Nachweis wird von einer Plattform geschrieben, die wir kontrollieren – nicht nur vom Anbieter. | Nachweis |
☐ | 6. Wir könnten einem Prüfer zeigen, welches Modell vor sechs Monaten eine bestimmte Antwort erzeugt hat. | Nachweis |
☐ | 7. Sensible Datenkategorien sind an Modelle gebunden, die auf unserer eigenen Infrastruktur laufen. | Kontrolle |
☐ | 8. Keine Anfrage verlässt unsere Infrastruktur, es sei denn, unsere Richtlinie erlaubt es. | Kontrolle |
☐ | 9. Wir haben das Modell evaluiert, das uns tatsächlich geliefert wird – nicht nur das aus der Verkaufspräsentation. | Kontrolle |
☐ | 10. Wir haben getestet, was unsere KI tut, wenn ein vorgelagertes Modell gesperrt wird. | Kontrolle |
Ihr Ergebnis:
8–10 Kreuze | Ihre Antworten tragen ihre Herkunft. Sie könnten beweisen, welches Modell jede von ihnen erzeugt hat. |
4–7 Kreuze | Einige Ihrer Antworten stammen von Modellen, die Sie nicht gewählt haben. Beginnen Sie mit dem Nachweis – das ist das Einzige, was ein Anbieter Ihnen im Nachhinein nicht geben kann. |
0–3 Kreuze | Sie vertrauen einem Etikett. |
Was das für europäische Unternehmen bedeutet
In Europa ist verstecktes Routing nicht nur eine Frage guter Praxis. Unter der DSGVO darf ein Auftragsverarbeiter keinen weiteren Auftragsverarbeiter einschalten, ohne die vorherige schriftliche Genehmigung des Verantwortlichen – und die Übermittlung personenbezogener Daten außerhalb des Europäischen Wirtschaftsraums unterliegt eigenen Regeln.¹¹ Ein KI-Anbieter, der Anfragen mit personenbezogenen Daten stillschweigend an einen anderen Modellanbieter weiterleitet, fügt faktisch einen Unterauftragsverarbeiter hinzu, den sein Kunde nie genehmigt hat. Die Pferdefleisch-Kette ist ein treffendes Bild dafür, wie das im großen Maßstab aussieht: Jedes Glied gibt das Produkt weiter, keines ist dem Kunden am Ende gegenüber rechenschaftspflichtig. Die meisten europäischen Datenschutzbeauftragten möchten von einer solchen Kette erfahren, bevor sie existiert – nicht aus einem Bedrohungsbericht.
Die praktische Antwort ist die von 2013, angewendet auf Antworten statt auf Lasagne: Vertrauen Sie nicht dem Etikett. Testen Sie, was drin ist. Verlangen Sie, dass die Herkunft angegeben wird – welches Modell, welche Version, wo es lief – und zwar anfragenweise aufgezeichnet, von einer Plattform, die Sie kontrollieren, nicht nur vom Anbieter. Für Daten, die das Gebäude nicht verlassen dürfen, binden Sie sie an Modelle, die auf Ihrer eigenen Hardware laufen. Open-Weight-Modelle auf Ihren eigenen Servern können eine Anfrage nirgendwohin weiterleiten. Das ist ihr Sinn.
Wo neuland.ai steht
Der neuland.ai HUB verteilt Aufgaben zwischen Modellen – und genau deshalb zeichnet er das Routing auf. Jede Aufgabe wird gemäß der eigenen Richtlinie des Kunden verteilt: über intern gehostete Open-Weight-Modelle wie Mistral, Nemotron, GLM, Qwen und DeepSeek sowie proprietäre Modelle wie Claude und GPT, wo der Kunde sie erlaubt. Jede Anfrage wird mit dem Modell aufgezeichnet, das sie bearbeitet hat – zusammen mit den Abrufen, Tool-Aufrufen und Entscheidungen drumherum – in einem Nachweis, der dem Kunden gehört. Datenkategorien können an Modelle gebunden werden, die auf der eigenen Infrastruktur des Kunden laufen, und der Aufruf eines externen Modells ist eine Richtlinienentscheidung des Kunden – kein Standard, den die Plattform für ihn trifft.¹²
Das ist auch die Antwort auf eine Frage, die wir von Datenschutzbeauftragten immer häufiger hören: Können Sie uns sagen, welches Modell eine bestimmte Antwort erzeugt hat? Ja – anfragenweise, und sechs Monate später.
Persönliches Fazit
Ein Wort zur Fairness. Die Fakten im Zentrum dieses Beitrags sind Vorwürfe eines Unternehmens gegen mehrere seiner Wettbewerber, zu einem Zeitpunkt, an dem dieses Unternehmen jeden Grund hat, seinen Fall lautstark zu vertreten. Die genannten Labore hatten nicht reagiert, als der Bericht erschien, und China hat die einen Tag zuvor veröffentlichte amerikanische Warnung zurückgewiesen. Nichts davon ist geklärt, und dieser Beitrag versucht nicht, es zu klären.
Wogegen ich mich ausspreche, ist etwas, das nicht davon abhängt, wer recht hat: die Gewohnheit, die Marke eines KI-Produkts als Beweis für seinen Inhalt zu behandeln. 2013 lernte Europa auf die teure Art, dass ein Etikett auf einer Packung eine Behauptung ist, kein Nachweis – und dass die einzige verlässliche Antwort darin besteht, den Inhalt zu testen und seine Herkunft zurückzuverfolgen. Enterprise-KI hat diese Lektion noch nicht gelernt. Bis Regulatoren dort ankommen, kann jedes Unternehmen es für sich selbst tun.
Wir bei neuland.ai stempeln lieber jede Antwort mit dem Modell, das sie erzeugt hat, als unsere Kunden zu bitten, dem Etikett zu vertrauen.
[1] Alle Artikel der Reihe verfügbar unter: neuland.ai
[2] Anthropic, „Detecting and countering misuse of AI", Bedrohungsbericht, 10. September 2026, Zeitraum Dezember 2025 bis August 2026; berichtet von CNBC (11. September 2026), South China Morning Post (11. September 2026) und Better Stack (14. September 2026). Gesamtzahl von rund 190 Millionen Anfragen über alle sieben Labore laut Berichterstattung.
[3] Startup Fortune und Quartz, September 2026, zu weitergeleiteten Anfragen, die Berichten zufolge polizei- und militärbezogenes Material enthielten, darunter eine Nutzeranfrage mit angehängtem Videomaterial.
[4] Volksrepublik China, Gesetz zum Schutz personenbezogener Informationen (2021) und Datensicherheitsgesetz (2021), einschließlich der Regeln für grenzüberschreitende Übermittlungen personenbezogener Informationen.
[5] The Information, berichtet von The Next Web, Quartz und AI Weekly, 22.–23. September 2026, zur Einbestellung aller sieben Unternehmen durch die Cyberspace Administration of China und zur Verengung der Untersuchung auf DeepSeek und Moonshot; The Next Web zur NSA-, FBI- und CISA-Warnung vom 9. September 2026 und Chinas Zurückweisung am 10. September 2026.
[6] Startup Fortune, Oktober 2026, zum Verbot von DeepSeek für zivile Bundesbehörden und Regierungsaufträge durch das US-Heimatschutzministerium als Lieferkettenrisiko.
[7] Zum Pferdefleischskandal 2013: Europäische Kommission, „Pferdefleisch – Fragen und Antworten", zu den Befunden irischer Kontrolleure im Januar 2013, Findus-Rindfleischlasagne von Comigel mit 80 bis 100 Prozent Pferdefleisch und dem EU-weiten Testprogramm; en.wikipedia.org zu den am 15. Januar 2013 bekannt gegebenen FSAI-Ergebnissen; NBC News, Februar 2013, zum Bericht der französischen Behörden über rumänische Schlachthöfe sowie niederländische und zypriotische Händler in der Lieferkette; REHIS, „Horse meat scandal — a decade on" (2023), zum Fehlen von Pferdetests in Rindfleisch vor 2013 und zum EU-weiten DNA-Testprogramm.
[8] Siehe den früheren Beitrag dieser Reihe zum KI-Kapitalgeflecht und zu europäischen Schaufenstern für amerikanische Modelle.
[9] Siehe den früheren Beitrag dieser Reihe zur Blind-Evaluierung und zum anonymen Modell Ox Alpha.
[10] Siehe den früheren Beitrag dieser Reihe zum KI-Kapitalgeflecht, einschließlich der Standard-Trainingseinstellungen von Consumer- und Enterprise-KI-Tarifen.
[11] Verordnung (EU) 2016/679 (DSGVO), Artikel 28 Absatz 2, zur Einschaltung eines weiteren Auftragsverarbeiters nur mit vorheriger spezifischer oder allgemeiner schriftlicher Genehmigung des Verantwortlichen, sowie Kapitel V zur Übermittlung personenbezogener Daten in Drittländer.
[12] neuland.ai HUB: aufgabenbasiertes Modell-Routing gemäß kundenseitig festgelegter Richtlinien über selbst gehostete Open-Weight- und proprietäre Modelle; anfragenweiser Nachweis des verwendeten Modells samt Abrufen, Tool-Aufrufen und Entscheidungen in einem unveränderlichen, kundeneigenen Audit-Protokoll; Bindung von Datenkategorien an Modelle auf Kundeninfrastruktur; Bereitstellung on-premises, in einer europäischen Sovereign Cloud oder air-gapped. Die neuland.ai AG trägt die Verantwortung für die inhaltliche Qualität und die saubere Lieferung von Ergebnissen in allen Kundenprojekten.
Von der KI-Strategie zur laufenden Plattform: Wir zeigen Ihnen den Weg.
Gespräch anfragen